Ein Startup eines Ex-OpenAI-Mitarbeiters will eine revolutionäre neue KI-Technologie entwickelt haben - um Entscheidungen mit KI zu verbessern, zu verbilligen und zu beschleunigen. Don't believe the hype; ich habe nachgeprüft: Kann "Jev" erkennen, welche Merkmale ein Text hat? Tatsächlich klappt das erstaunlich gut - und gibt uns ein neues Werkzeug in die Hand.
Am Freitag hat Typesafe.ai sein Entscheidungs-Modell Jev veröffentlicht - und ich habe relativ schnell das Glück gehabt, einen API-Zugang zu bekommen und ein wenig spielen zu können. Meine ersten Versuche haben ergeben:
- Es ist einfach, eine Frage so aufzubereiten, dass Jev sie einschätzen und entscheiden kann.
- Die Einschätzungen sind vergleichsweise stabil und dicht an dem, was ein Sprachmodell entscheiden würde.
- Dabei ist das Modell deutlich effizienter - und kann dadurch auch viel günstiger sein.
Kurz gesagt: Ich startete mit dem Verdacht, dass das wieder nur eine übertriebene Marketingmeldung ist, begeistertes Grundrauschen bei Reddit hin oder her. Und hatte ein wenig wieder so ein Gefühl, wie ich es hatte, als ich das erste Mal ein Sprachmodell dazu brachte, einen Fragebogen für mich auszuwerten - noch nicht perfekt, aber: das kann was Großes werden.
Was Jev überhaupt ist - und wie es sich von anderen Sprachmodellen unterscheidet
- Geht es in dieser Polizeimeldung um einen gesprengten Geldautomaten?
- An wen soll mein Agent eine Information weiterleiten?
- Enthält der Text Meinung oder nicht?
Solche Fragen kann KI schon beantworten. Man kann die Entscheidung ganz einfach durch ein großes Sprachmodell treffen lassen, wie GPT-5, Opus oder Mistral. Dazu schiebt man die Information, die es zu beurteilen gibt, als Text in das Sprachmodell, gemeinsam mit einem Systemprompt, der dem Modell vorgibt, worauf es seine Einschätzung gründen soll - und in welcher Form es antworten soll: "Antworte nur mit einer JSON-Datei in der angegebenen Form. Erkläre nicht, gib nur Zahlen zwischen 1 und 10 aus."
Selbst mit einem kleinen Sprachmodell - sagen wir: ein qwen3.5-4b - ist das ein erheblicher Rechen- und Zeitaufwand. Erschwerend kommt hinzu, dass es manchmal mehrere Anläufe braucht, bis das Modell sich auch an die Formatvorgabe hält; Sprachmodelle sind eben geschwätzig.
Jev kann gar nicht herumschwafeln: Ein Sprachmodell, das eine Frage vorgelegt bekommt - und statt eines Antworttextes eine Entscheidung ausgibt. Anbieter Typesafe bezeichnet Jev als "the first System 1 model", in Bezug auf Daniel Kahnemans "Schnelles Denken, Langsames Denken": Jev soll nicht das Nachdenken über ein Problem liefern, sondern eine schnelle Assoziation.
Experiment 1: Text-Aussagen klassifizieren
Ich war vergangene Woche auf der SCICAR, der kleinen, aber sehr feinen Datenjournalismus-Konferenz in Dortmund. Während ich noch daran herumdachte, was man denn mit dem neuen Jev-Testzugang so machen kann, besuchte ich einen Vortrag von Felix Bießmann (🌐 Calgo Lab), der mit einer Studentin 🌐 "Presspulse"" vorgestellt hat. In "Presspulse" geht es darum, Zeitungsartikel mit KI in ihrer Tendenz zu verorten - befassen sich die Artikel mit Wirtschaft oder Kultur, lassen sie eine eher positive oder negative Haltung zu Bürokratieabbau, Sozialstaat, militärischer Rüstung erkennen.
Die Methodik haben Bießmann und sein Team beim 🌐 "Manifesto"-Projekt entliehen, bei dem (menschliche) Codierer die Wahlprogramme aus allen europäischen Wahlen durchgehen und Aussage für Aussage klassifizieren. Auf dieser Basis haben sie ein BERT-Modell trainiert - ein etwas älteres, aber sehr effizientes Sprachmodell - und das Presspulse-Team hat "Manifestobert" wiederum weiterentwickelt: Das Modell geht jetzt täglich die Kommentare durch, die in der Deutschlandfunk-Presseschau vorkommen, und verortet sie.
Und ich dachte mir: Eine Aussage klassifizieren und eine Tendenz dafür oder dagegen herauslesen - kann Jev das auch? Während des nächsten Vortrag habe ich einen Coding-Agenten eine kleine Demo bauen lassen, und gesagt: zieh doch mal die Kommentar-Auszüge von der Presspulse-Seite, bewerte sie mit Jev, und vergleich das mit dem, was Presspulse selber gemessen hat.
Jev antwortet mit einer von drei Antworttypen:
| Question type | Goal | Returns |
|---|---|---|
| Choice | Choose an option from a list | choice, probabilities, confidence |
| Score | Score the state on a rubric | score, probabilities, confidence |
| Noul | Is this statement true? | noul (0–1) |
Ich wollte wissen: funktioniert das? Und wie gut ist das Modell darin, Entscheidungen über Texte zu treffen?
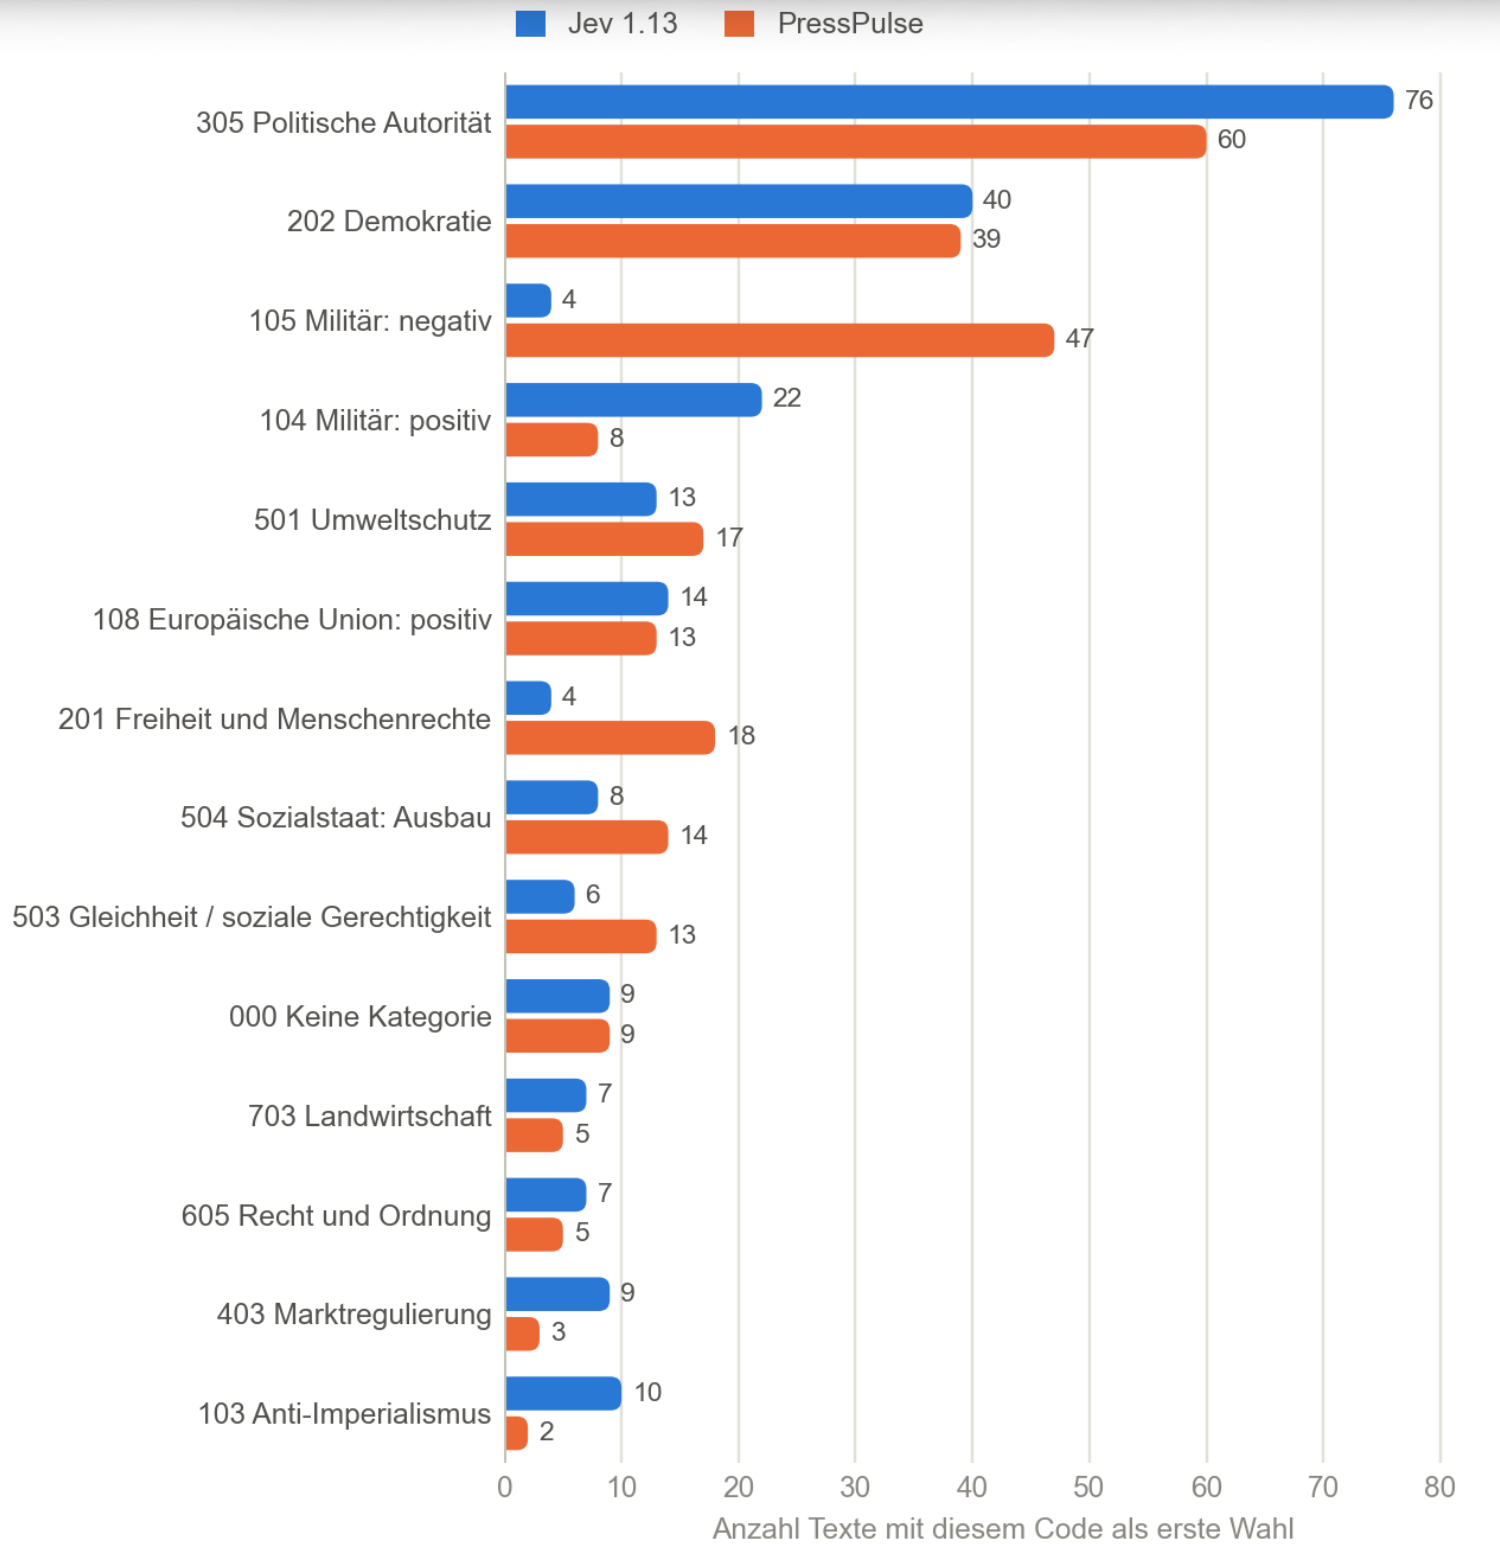
An sich ist der Vergleich Blödsinn, die Methoden sind zu unterschiedlich: Im Presspulse- und Manifesto-Projekt wird der Text in einzelne Teilaussagen aufgegliedert, und diesen wird dann ein Marker zugeordnet (zum Beispiel: "202.4 Direct Democracy: Positive"). Jev hat den ganzen Text bekommen und sollte direkt die drei häufigsten Zuordnungen angeben.
Wie