Die Bauchgefühl-KI: Mit "Jev" Texte schnell und gut ausmessen?
Ein Startup eines Ex-OpenAI-Mitarbeiters will eine revolutionäre neue KI-Technologie entwickelt haben - um Entscheidungen mit KI zu verbessern, zu verbilligen und zu beschleunigen. Don't believe the hype; ich habe nachgeprüft: Kann "Jev" erkennen, welche Merkmale ein Text hat? Tatsächlich klappt das erstaunlich gut - und gibt uns ein neues Werkzeug in die Hand.
Am Freitag hat 🌐 Typesafe.ai sein Entscheidungs-Modell Jev veröffentlicht - und ich habe relativ schnell das Glück gehabt, einen API-Zugang zu bekommen und ein wenig spielen zu können. Meine ersten Versuche haben ergeben:
- Es ist einfach, eine Frage so aufzubereiten, dass Jev sie einschätzen und entscheiden kann.
- Die Einschätzungen sind vergleichsweise stabil und dicht an dem, was ein Sprachmodell entscheiden würde.
- Dabei ist das Modell deutlich effizienter - und kann dadurch auch viel günstiger sein.
Kurz gesagt: Ich startete mit dem Verdacht, dass das wieder nur eine übertriebene Marketingmeldung ist, begeistertes Grundrauschen bei Reddit hin oder her. Und hatte am Ende wieder so ein Gefühl, wie ich es hatte, als ich das erste Mal ein Sprachmodell dazu brachte, einen Fragebogen für mich auszuwerten - noch nicht perfekt, aber: das kann was Großes werden.
Wichtige Ergänzung, einen Tag später: Blogpost vom KI-Forscher Nandakishor Mukkunnoth, der genau das, was Jev jetzt macht, schon gebaut, getestet, publiziert und open-source gestellt hatte - vor einem Jahr. Und weshalb er meint, dass seine nachgeschärfte Engine dem Jev-Modell überlegen ist. Meine ersten Tests mit dem Steingart-Korpus konnten das allerdings überhaupt nicht bestätigen, auch wenn seine Behauptungen sonst soweit zu stimmen scheinen: für deutsche Texte ist Laya derzeit unbrauchbar.
Was Jev überhaupt ist - und wie es sich von anderen Sprachmodellen unterscheidet
- Geht es in dieser Polizeimeldung um einen gesprengten Geldautomaten?
- An wen soll mein Agent eine Information weiterleiten?
- Enthält der Text Meinung oder nicht?
Solche Fragen kann KI schon beantworten. Man kann die Entscheidung ganz einfach durch ein großes Sprachmodell treffen lassen, wie GPT-5, Opus oder Mistral. Dazu schiebt man die Information, die es zu beurteilen gibt, als Text in das Sprachmodell, gemeinsam mit einem Systemprompt, der dem Modell vorgibt, worauf es seine Einschätzung gründen soll - und in welcher Form es antworten soll: "Antworte nur mit einer JSON-Datei in der angegebenen Form. Erkläre nicht, gib nur Zahlen zwischen 1 und 10 aus."
Selbst mit einem kleinen Sprachmodell - sagen wir: ein qwen3.5-4b - ist das ein erheblicher Rechen- und Zeitaufwand. Erschwerend kommt hinzu, dass es manchmal mehrere Anläufe braucht, bis das Modell sich auch an die Formatvorgabe hält; Sprachmodelle sind eben geschwätzig.
Jev kann gar nicht herumschwafeln: Ein Sprachmodell, das eine Frage vorgelegt bekommt - und statt eines Antworttextes eine Entscheidung ausgibt. Anbieter Typesafe bezeichnet Jev als "the first System 1 model", in Bezug auf Daniel Kahnemans "Schnelles Denken, Langsames Denken": Jev soll nicht das Nachdenken über ein Problem liefern, sondern eine schnelle Assoziation.
Experiment 1: Text-Aussagen klassifizieren
Ich war vergangene Woche auf der 🌐 SCICAR, der kleinen, aber sehr feinen Datenjournalismus-Konferenz in Dortmund. Während ich noch daran herumdachte, was man denn mit dem neuen Jev-Testzugang so machen kann, besuchte ich einen Vortrag von Felix Bießmann (🌐 Calgo Lab), der mit einer Studentin 🌐 "Presspulse"" vorgestellt hat. In "Presspulse" geht es darum, Zeitungsartikel mit KI in ihrer Tendenz zu verorten - befassen sich die Artikel mit Wirtschaft oder Kultur, lassen sie eine eher positive oder negative Haltung zu Bürokratieabbau, Sozialstaat, militärischer Rüstung erkennen.
Die Methodik haben Bießmann und sein Team beim 🌐 "Manifesto"-Projekt entliehen, bei dem (menschliche) Codierer die Wahlprogramme aus allen europäischen Wahlen durchgehen und Aussage für Aussage klassifizieren. Auf dieser Basis haben sie ein BERT-Modell trainiert - ein etwas älteres, aber sehr effizientes Sprachmodell - und das Presspulse-Team hat "Manifestobert" wiederum weiterentwickelt: Das Modell geht jetzt täglich die Kommentare durch, die in der Deutschlandfunk-Presseschau vorkommen, und verortet sie.
Und ich dachte mir: Eine Aussage klassifizieren und eine Tendenz dafür oder dagegen herauslesen - kann Jev das auch? Während des nächsten Vortrag habe ich einen Coding-Agenten eine kleine Demo bauen lassen, und gesagt: zieh doch mal die Kommentar-Auszüge von der Presspulse-Seite, bewerte sie mit Jev, und vergleich das mit dem, was Presspulse selber gemessen hat.
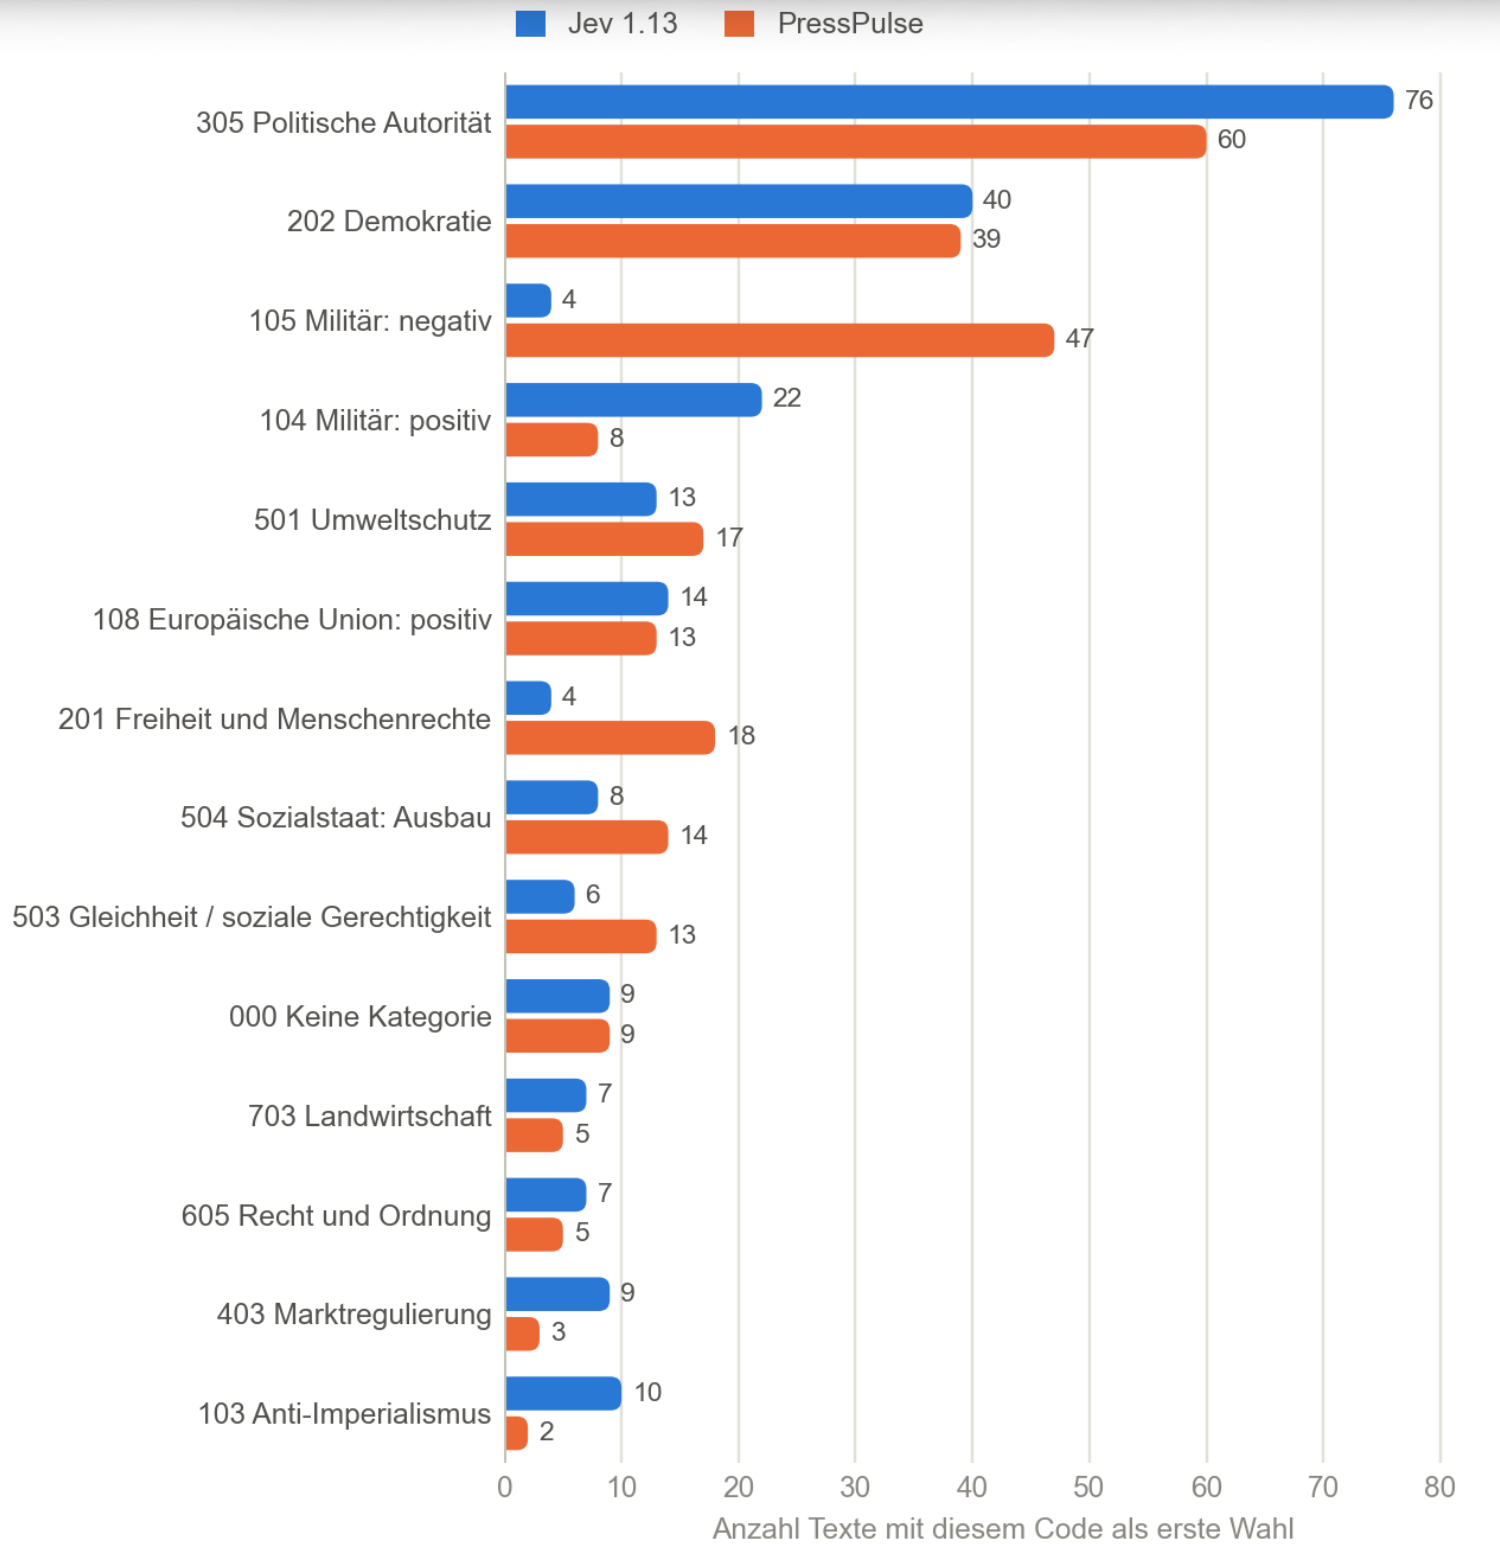
An sich ist der Vergleich Blödsinn, die Methoden sind zu unterschiedlich: Im Presspulse- und Manifesto-Projekt wird der Text in einzelne Teilaussagen aufgegliedert, und diesen wird dann ein Marker zugeordnet (zum Beispiel: "202.4 Direct Democracy: Positive"). Jev hat den ganzen Text bekommen und sollte direkt die drei häufigsten Zuordnungen angeben. Aber auch dieser Vergleich unterschiedlichen Disziplinen zeigt: Jev misst das Richtige.
- Jev liefert eindeutig eine ähnliche Tendenz - das zeigt die Rangliste der Kategorien - aber weicht im Einzelnen klar von den Bewertungen des nachtrainierten ManifestoBERT-Modells in Presspulse ab.
- An einer Stelle sind die Modelle klar unterschiedlicher Meinung: ob Erwähnungen von Militär kritisch oder unterstützend zu werden sind. Die Jev-Wertung erscheint mir plausibler.
Wieviel Steingart ist dein Text? Das soll jetzt Jev entscheiden
Der erste Schnelltest war jedenfalls eine Ermutigung, sich Jev noch einmal mit einem direkten Vergleich anzusehen, und deshalb habe ich das "Steingart-o-Meter" umgebaut, mein kleines sarkastisches Experiment zum Ausmessen der Zuspitzung eines Textes. Es beurteilt einen Text mit drei Prompts, die drei unterschiedliche Dimensionen messen sollen:
- Ahnung - wie differenziert und informiert gibt sich der Text?
- Meinung - wie sehr hat er eine einzige Tendenz und tut andere Positionen ab?
- Zuspitzung - wie sehr übertreibt und verkürzt er aus dramaturgischen Gründen?
Man sieht, die drei Dimensionen sind nicht wirklich unabhängig voneinander, und meine Formel "Steingart gleich Ahnung durch Meinung mal Steilheit der These" ist auch nicht zu Ende gedacht, aber ich will ja das Werkzeug vermessen, nicht den Autor. Und diese Vermessung liefert sehr beeindruckende Ergebnisse - vor allem im Vergleich zu einem Mistral-Medium-3.5-Modell, das meiner Erfahrung nach sehr gut darin ist, deutsche Texte zu klassifizieren.
Das Erstaunlichste: Der "Steingart-Score" scheint tatsächlich reproduzierbar etwas zu messen - was auch immer es ist. Die Scores von Mistral und Jev korrelieren fast perfekt - r=0,808± 0,002 (die Teilmessungen: "Meinung" 0,774, "Ahnung" 0,723, "Zuspitzung" 0,867) Und während das Mistral-Sprachmodell die üblichen zufallsbedingten Schwankungen aufweist und bei manchen der fünf Test-Durchläufe deutlich gestreut hat - in der Grafik sind das die roten Flächen, die die Standardabweichung zeigen - sind die Jev-Scores bei jedem Aufruf praktisch identisch. Vielleicht arbeitet das Modell nicht mit einem Seed-Zufallswert zum Start, aber auch das ist gut zu wissen: Bei Jev bekommt man, anders als bei herkömmlichen großen Sprachmodellen, bei jedem Durchlauf das Gleiche raus.
Das wiederum hat ganz erheblichen Einfluss auf die Effizenz und die Kosten. Mein üblicher Trick, Klassifizierer gegen die Streuung eines LLM zu härten, ist ein "best of three" - mehrmals fragen. Das kostet Zeit und Geld. Dabei ist das Mittelklasse-Mistral gegenüber Jev ohnehin massiv im Nachteil: Die Tokens im Test mit Mistral kosteten 26x mehr als die Jev-Aufrufe. Und das, obwohl die Anbieterfirma in der FAQ behauptet, man arbeite nicht wie üblich mit subventionierten Preisen, sondern kostendeckend.
Ehe wir uns anschauen, wie man denn nun konkret mit Jev arbeitet, das Zugeständnis an die Nerds: ja, Mistral-Medium-3.5 könnte man als Open-Weights-Modell auch lokal betreiben, zu Kosten pro Token nahe null, aber dafür braucht man bessere Hardware und mehr Geduld, als mir zur Verfügung steht; als monolitisches Modell fühlt es sich auf eigenen Rechnern trotz guter Ergebnisse sehr schwerfällig und groß an - believe me, I've tried.
Von Jev Resultate bekommen
Jev kann drei Arten von Fragen beantworten:
| Question type | Goal | Returns |
|---|---|---|
| Choice | Choose an option from a list | choice, probabilities, confidence |
| Score | Score the state on a rubric | score, probabilities, confidence |
| Noul | Is this statement true? | noul (0–1) |
In jedem Fall gibt man dem Modelle den Kontext, also das, was zu beurteilen ist, und die Fragen dazu. Der Funktionsaufruf ist dann einfach:
results = system_one(state = kontext, questions)Schauen wir uns das mal für eine vereinfachte Form unserer Ahnungs-Messung an, also der Antwort auf die Frage: wie differenziert und faktenbasiert zeigt sich der Text, den wir in die Variable state kopiert haben. Das Modell soll mit einem Messwert antworten; zur Orientierung geben wir ihm Kriterien vor, wie die Stufen einer Leiter vor - hier eine dreistufige:
{
  "questions": {
    "ahnung": {
      "type": "score",
      "instructions": "Beurteile die faktische Qualität des Textes: wie er sich mit den Fakten auseinandersetzt. Bewerte nicht das Thema, sondern den Text. Miss ihn an einer neutralen, nicht wertenden journalistischen Darstellung des Themas.",
      "criteria": [
        "Steht im Widerspruch zur Faktenlage, Fakten fehlen oder sind falsch",
        "Solide Grundfakten, die Auswahl stützt erkennbar eine Position",
        "Breite Faktenbasis, Quellen fair behandelt, Unsicherheiten benannt"
        ]
    }
  }
}
Die zusätzlichen instructions - gewissermaßen der System-Prompt - hat dabei einen weniger starken Einfluss auf das Ergebnis als die einzelnen Kriterien - anders als bei großen Sprachmodellen.
Wenn ich den Text auf mehrere Merkmale hin klassifizieren oder auswerten will, muss ich dafür nicht mehrere Aufrufe starten - sondern einfach nur mehrere Fragen formulieren und im Aufruf mitgeben. Auch das macht Jev so ungeheuer effizient: Die Einschätzung von Ahnung, Meinung und Thesenwinkel kann in einem Aufruf erfolgen, nicht in drei.
- Den gesamten Demo-Code und zwei von Claude verfasste Auswertungen der Experimente findet ihr im 🌐 Repository https://git.h2h.de/Jan/jev_grading_test.
Fazit
Mich hat Jev beeindruckt - und scheint mir ein weiterer Schritt aus der Klemme zu sein, in die wir uns dadurch manövriert haben, dass Sprachmodelle billig, einfach und verfügbar sind, und wir diesen Riesen-Apparat inzwischen selbst für so absurde Einsatzzwecke wie eine Rechtschreibkorrektur einsetzen. Oder eben, um Merkmale eines Textes zu quantifizieren. Man muss sich das mal vorstellen: das ausgedruckte gesamte Internet, auf dutzende Gigabyte eines neuronalen Netzes zusammengequetscht, das wir jetzt für jedes einzelne Wort von vorn bis hinten durchrödeln, nur das Ergebnis der semantischen Analyse dann am Ende wieder in eine Zahl zu verwandeln.
Jev ist eine effiziente und präzise Lösung für Klassifizierungs-Aufgaben: von der Auswahl des richtigen Sprachmodells über den Job (oder des richtigen Sachbearbeiters bzw. Prompts) über die Filterung von Meinungsstücken oder konkreten Prognosen aus einem Textkorpus bis hin zur Entscheidung auf Basis einer Information.
Und weil die Technik nun vergleichsweise neu ist, glaube ich: wir werden bald sehen, wie sie sich entwickelt und Standard wird, und dann gibt es auch offene Versionen davon, die man lokal einsetzen kann.
Und wieder einmal wird die Technik ein Stück alltagstauglicher.