Mein ChatGPT-Ersatz für die ganze Familie
Abhängig von ChatGPT, von Gemini, Claude - oder ja, auch von Mistral? Höchster Zeit für einen Ersatz, der nicht von einem Tech-Konzern kontrolliert wird! Eine Kombination von OpenWebUI, lokalen KI-Modellen und ein paar Hacks versorgt die Familie mit zeitgemäßer KI, die nichts mehr in die Cloud abstrahlt.
Tatsächlich ist ein Alltags-Ersatz für ChatGPT möglich: 🌐 OpenWebUI ist ein Projekt, das erlaubt, KI in einer eigenen Oberfläche zu nutzen. Diese KI-Oberfläche steht ChatGPT nicht nach, und ist Open-Source-Software, also kostenlos zu installieren und zu nutzen. Damit sie alltagstauglich wird, habe ich allerdings ein paar Hacks eingebaut.
Hack Nr. 1: Eigener Herd ist Goldes wert - kein Token mehr für OpenAI & Co.
OpenWebUI kann auch mit kommerzieller KI reden, über eine API - mehr Souveränität, mehr Kosten. Alternative: ein lokales KI-Modell auf dem eigenen Computer. Lieferant für KI-Leistungen ist bei mir ein eigens angeschaffter KI-PC: Ein Rechner mit 128GB Hauptspeicher und einem Strix-Halo-395+-Chipsatz von AMD - das war mal eine kostengünstige Alternative zu teuren Mini-Macs und Radeon-Karten, seit der KI-Goldrausch die Speicherpreise hochtreibt (🌐 pcgameshardware.de)](https://www.pcgameshardware.de/RAM-Hardware-154108/News/RAM-Preise-Niveau-2007-KI-Boom-Speicherkrise-1550615/), hat sich der Preis auf über 4.000 Euro verdoppelt. Zum Glück habe ich ihn schon.
Dank seiner 128GB Speicher, von denen 96GB am Stück als Grafikspeicher für KI-Modelle nutzbar sind, kann ich gleich fünf lokale KI-Systeme auf Abruf halten. Das ist ziemlich auf Kante genäht, aber zumindest die wichtigen können notfalls gleichzeitig aktiv sein:
- Die stärkste KI läuft in llama.cpp: Qwen3.8-Flash-Next, von 16 auf 3 Bit zusammengequetscht und so immer noch 70GB groß (und in etwa so leistungsstark wie eine kommerzielle Chatbot-KI vor anderthalb Jahren). Es ist ein "Mixture of Experts"-Modell mit einer effizienten und sparsamen Architektur.
- Mit Ollama ist die Verwaltung und das Ausführen von KI-Modellen recht einfach; als Standard quetscht sich ein Qwen3.8:27b (4 Bit, 18GB) neben seine große Schwester.
- Der AMD-Würfel hat eine NPU, einen Spezialchip für KI zusätzlich zur Grafikkarte, die die Berechnungen der großen KI ausführt. Die dafür nötige FastFlowLM-Bibliothek unterstützt meinen Linux-Rechner erst seit kurzem; sie führt kleine Modelle effizient aus, darunter ein Embedding-Modell (EmbeddingGemma:300m) und ein 2GB kleines Qwen3.5:4b-Modell.
- Ein weiterer Prozess führt auf der CPU ein 1GB kleines Transkriptions-Modell namens Canary aus, das von NVIDIA stammt, und gesprochene Sprache besser und schneller übersetzt als der Quasi-Standard "Whisper" von OpenAI.
- Und dann gibt es noch den Flux.2-klein:4b-Bildgenerator.
Wunder sollte man von so einem AMD-KI-Würfel nicht erwarten. KI, die lokal a läuft, antwortet deutlich langsamer als ein kommerzieller Chatbot in der Cloud. Die wahre Geduldsprobe ist dabei nicht die Geschwindigkeit, in der sie die Worte erzeugt, sondern die Wartezeit, bis sie überhaupt antwortet. Bei lokalen KI-Modellen ist die "Time to first token" entscheidend, die Zeit, die sie zur Verarbeitung des Prompts braucht, bis sie antwortet. Und bevor das große Qwen3.8-Flash-Next-Modell überhaupt arbeiten kann, müssen 70GB Gewichte erst einmal in den Speicher geladen werden; auch das dauert.
Wenn der Prompt nicht zu lang ist und nicht zu viele Tools berücksichtigen muss, ist die Wartezeit aber erträglich, und sobald sie losgelaufen ist, kommen die Antworten angenehm flüssig. Das kleinere Qwen-Modell antwortet insgesamt schneller, bei leichten Qualitätseinbußen; derzeit überlege ich aber, ob ich es nicht durch ein noch kleineres und schnelleres Gemma4 ersetze.
Dass der KI-Würfel bei alledem ziemlich heiß wird, ist eine Erinnerung daran, wie enorm viel Rechenleistung und Energie die KI-Modelle selbst bei der Inferenz erwarten. Eigener Herd indeed!
Hack Nr. 2: Immer die beste KI für den Job - Modell-Umschalter für OpenWebUI
"Für große Aufgaben nimmst du diese KI, für nicht so große Aufgaben diese" - das sind Details, mit denen sich die Familien-Userinnen nicht herumschlagen müssen wollen. Auch diese Arbeit kann ihnen eine KI abnehmen: Wie bei ChatGPT entscheidet ein vorgeschaltetes kleines Modell, welche KI zum Einsatz kommt. Das kleine Qwen3.5-Modell auf der NPU erfüllt diese Aufgabe flüssig und zuverlässig; die zusätzlichen zwei Sekunden Wartezeit bis zur ersten Antwort fallen kaum auf.
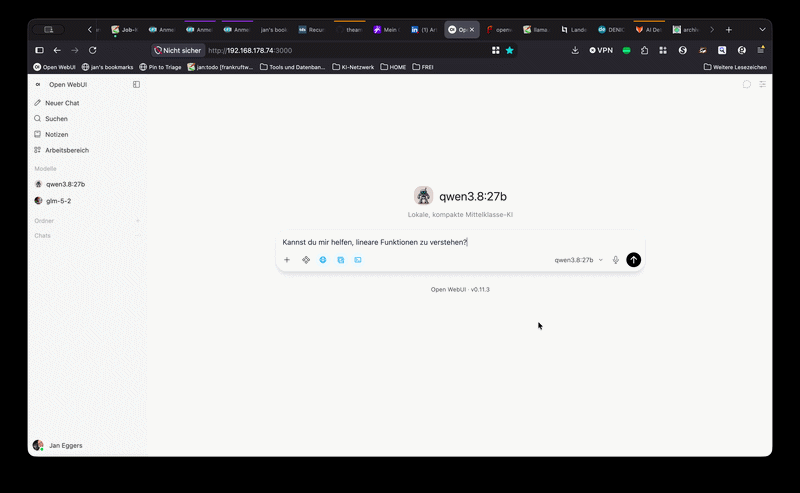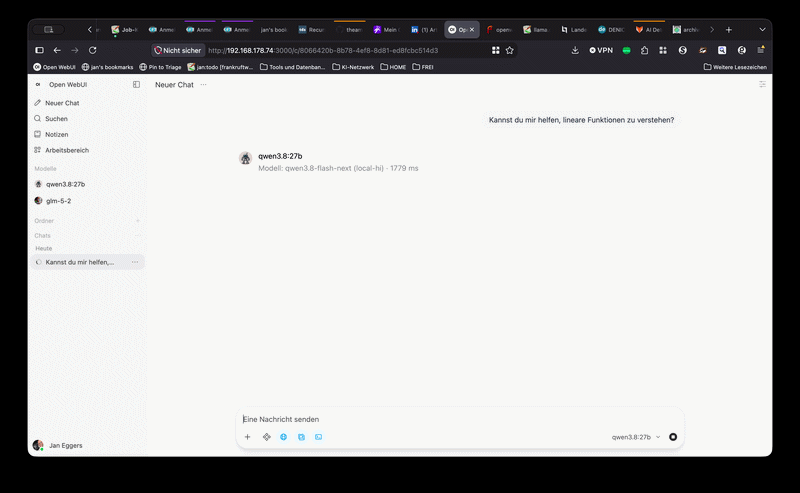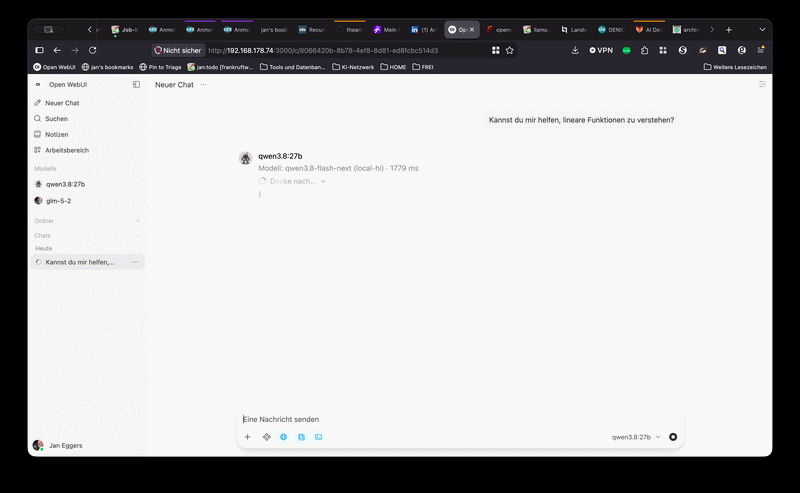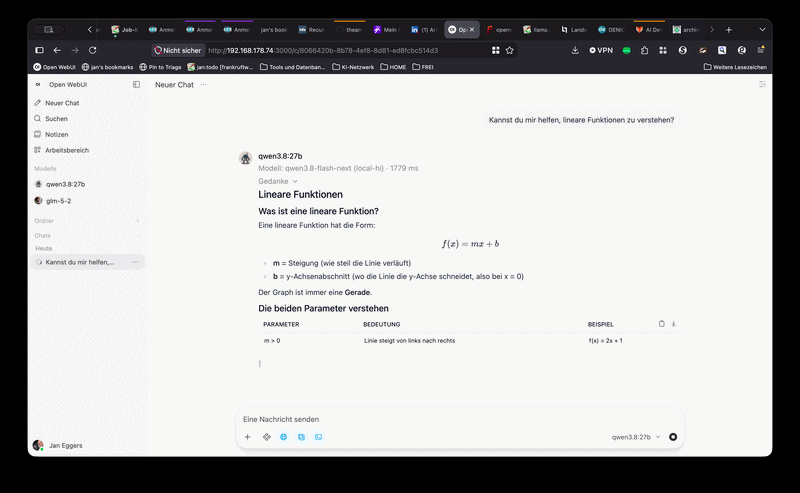
Es gibt Aufgaben, für die ist kommerzielle KI die bessere Lösung:
- Code schreiben, ein Projekt designen, große Kontexte schnell verarbeiten - das gibt man besser an eine externe KI wie meinen derzeitigen Preis-Leistungs-Favoriten Deepseek-V4-Flash.
- Aufgaben, bei denen es um journalistisches und sprachliches Feingefühl geht, sind beim Mistral-Medium-3.5-Modell gut aufgehoben.
Beide binde ich über 🌐 Cortecs.ai ein, eine europäische Alternative zu OpenRouter - datenschutzfreundlich. Sensible Aufgaben werden trotzdem auf die lokale KI geroutet.
Der Modell-Router lässt sich natürlich für den jeweiligen Chat auch abschalten, in den Optionen im Chatfenster - vor dem ersten Prompt, natürlich.
Hack Nr. 3: Frisierter Bibliothekar - das OpenWebUI-RAG aufbohren
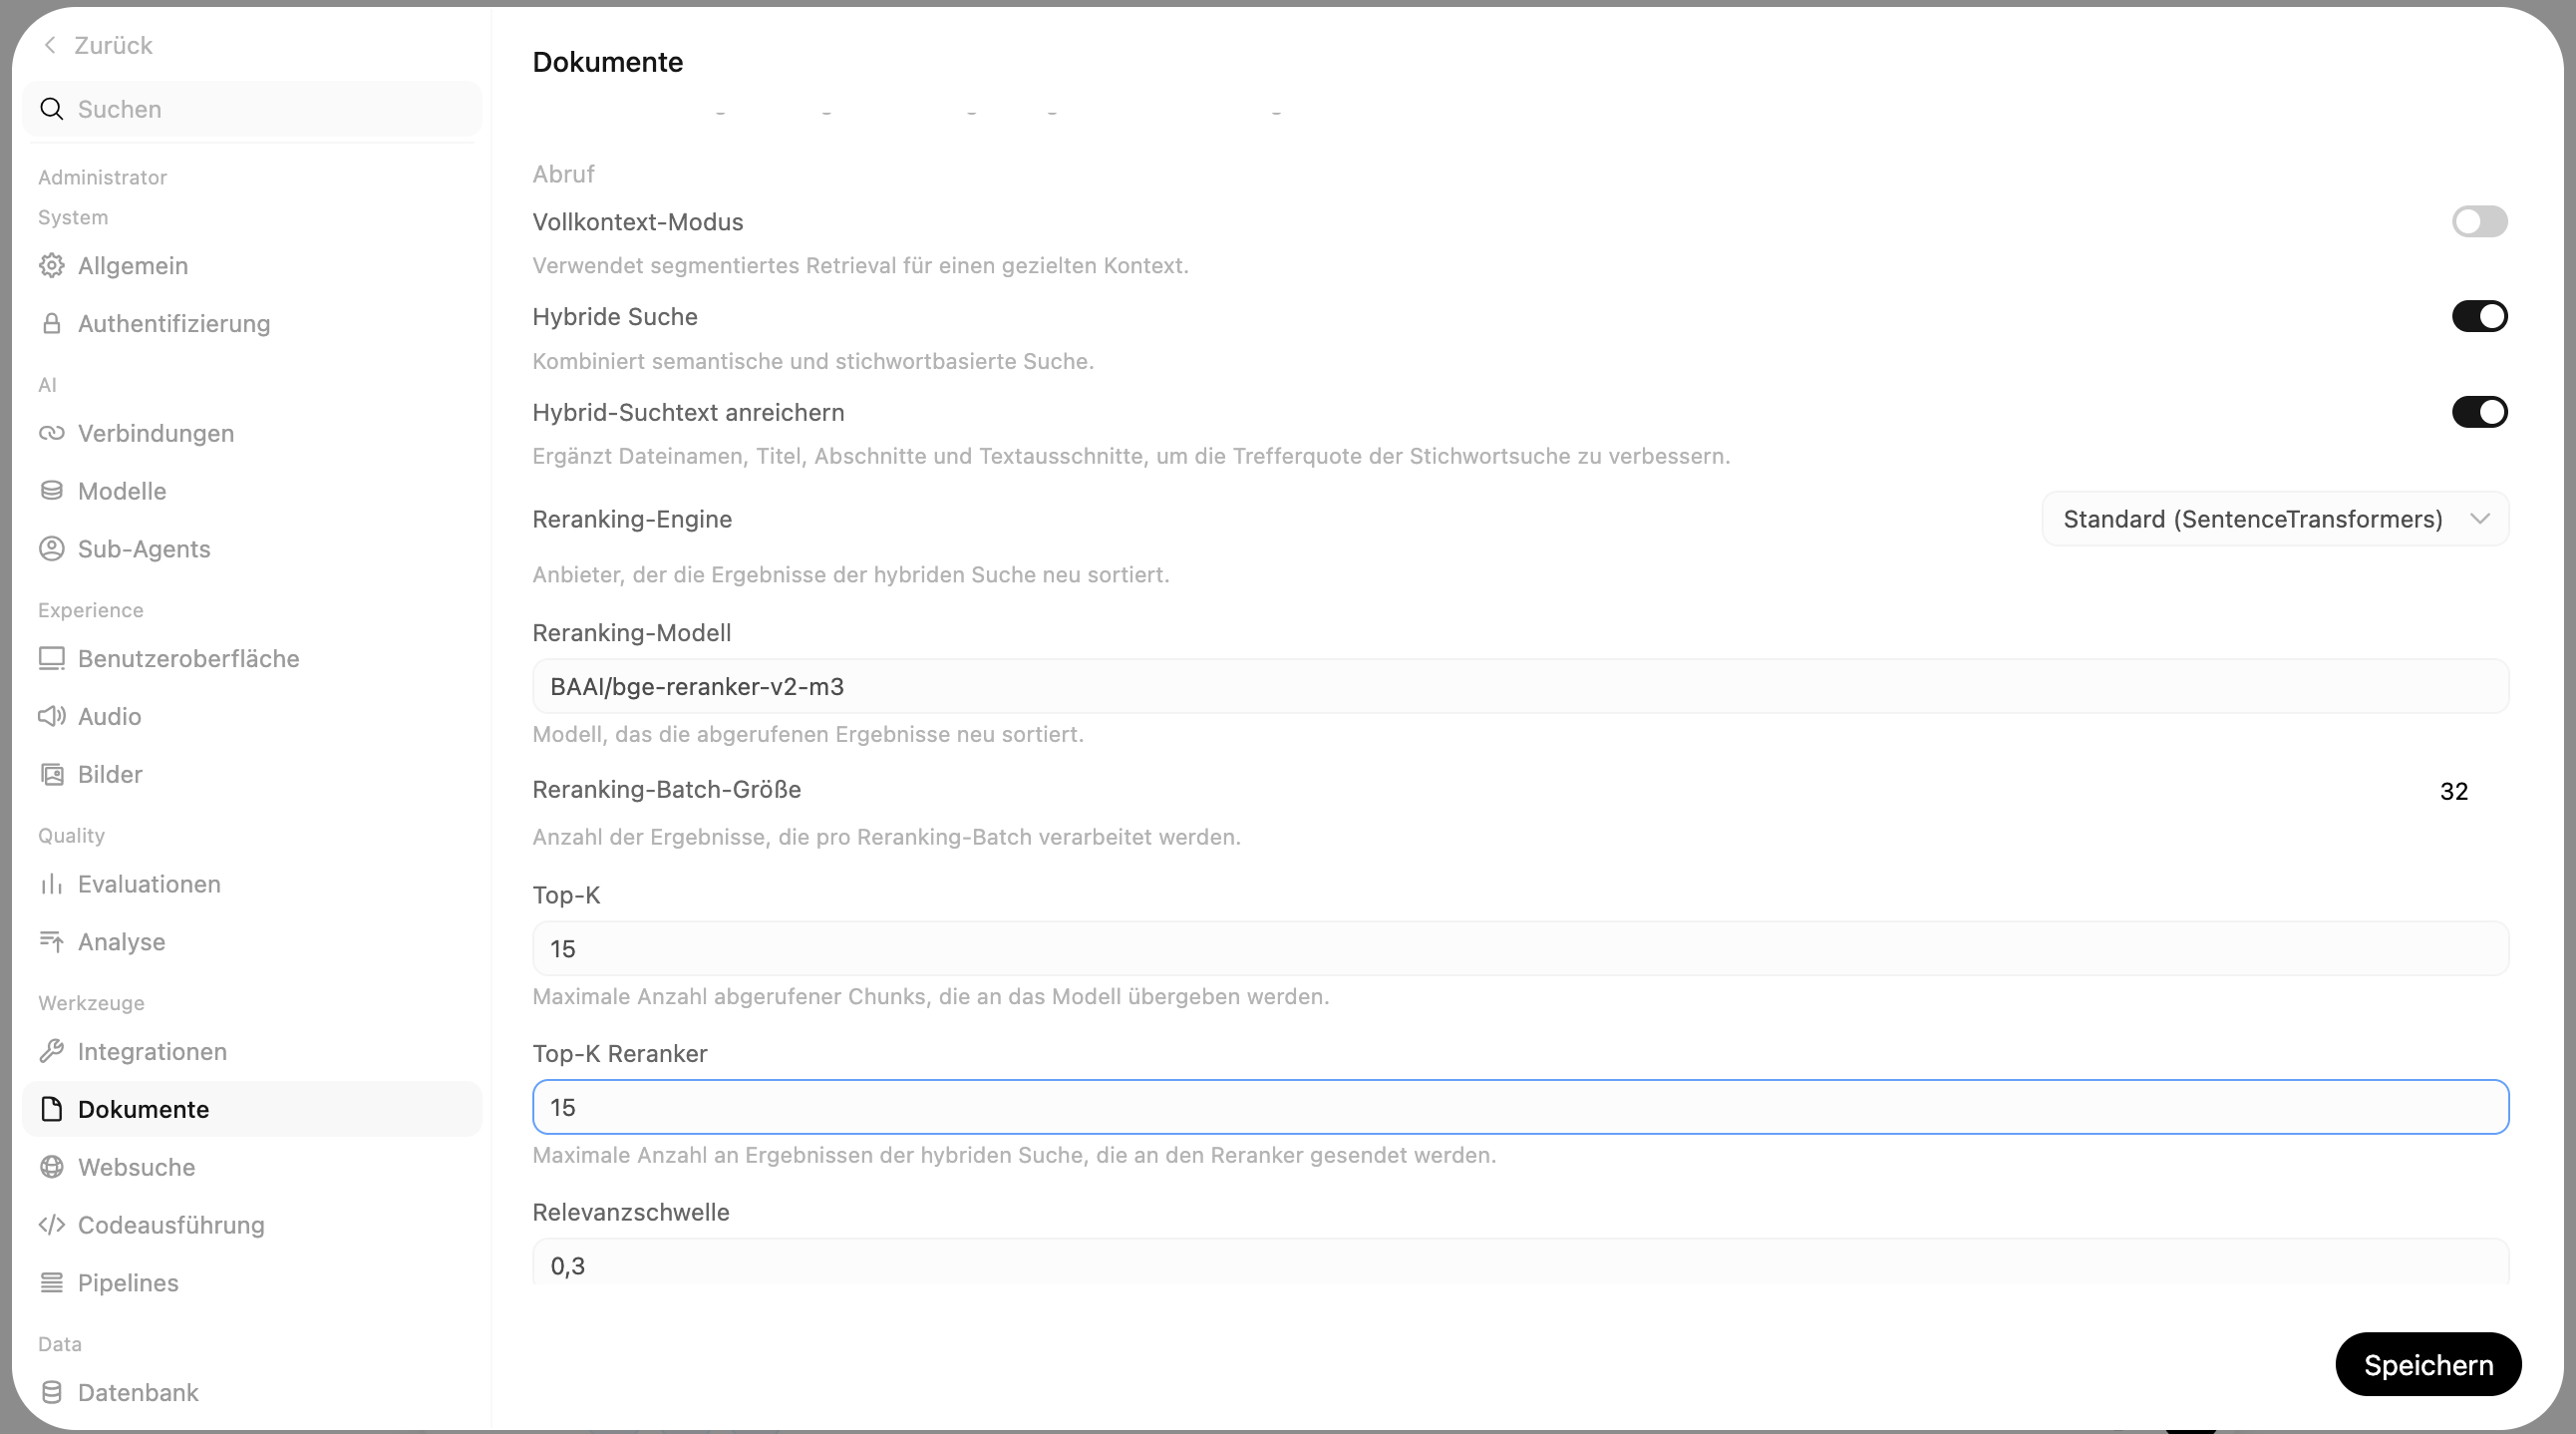
OpenWebUI bietet die Möglichkeit, der KI Werkzeuge zur Verfügung zu stellen, eine Websuche - und Wissen. Ein RAG-System erledigt das, ein Bibliothekar, der der KI immer genau die Schnipsel in den Kontext kopiert, die am besten zur Fragestellung passen. Das eingebaute RAG-System ist in der Voreinstellung allerdings nicht besonders gut. In den Einstellungen habe ich ein paar Anpassungen vorgenommen:
- Anzahl der verarbeiteten Wissens-Schnipsel von 5 auf 15 erhöht
- Reranking aktiviert (OpenWebUI bringt ein Modell dafür mit)
- Eine Mindest-Übereinstimmungs-Grenze von 0,3 aktiviert
- Das bessere embeddinggemma:300b-Modell aktiviert
- Hybridsuche: BM25-Stichwortsuche aktiviert, damit die KI nicht nur mit KI nach den besten Wissensbrocken sucht.
Hack Nr. 4: Quellencheck aus Prinzip und Sokrates als Hilfslehrer - clevere System-Prompts
Bei ChatGPT und Co. habe ich keine Kontrolle über den System Prompt, die Hausregeln für die KI. Bei OpenWebUI kann ich ihn ändern und der KI vorgeben: Sie soll mit Quellen argumentieren. Und ein speziell angepasster System Prompt mindert ein weiteres KI-Alltagsproblem.
Denn natürlich ist es problematisch, schulpflichtigen Kindern unbegrenzt KI in Hausaufgabenreichweite zu stellen. Warum selber Hausaufgaben machen, wenn der Assistent den blöden Aufsatz auch schreiben kann?
Das Problem, dass Kinder mit KI umgehen lernen müssen, kann Technik nicht lösen. Sie kann unterstützen: Die Jüngste bekommt ein eigenes Konto mit einem System-Prompt, der die Anweisung enthält: Liefere keine Lösungen, hilf der Nutzerin, selbst Lösung zu finden. Methode Sokrates.
Diesen Prompt speichert OpenWebUI als "Modell" - also wie eine andere KI. In dem Modell-Einstellungen bietet sie die Möglichkeit, diese Modelle gezielt für Nutzerkonten freizugeben. Die Jüngste bekommt den Hilfe-zur-Selbsthilfe-Prompt mit dem vergleichsweise schwachen lokalen Modell.
Hack Nr. 5: Signal-Agent - OpenWebUI über Messenger ansprechbar
Die OpenWebUI-Oberfläche kann man nur im Heim-WLAN-Netz nutzen. Für unterwegs lauscht der KI-Dienst auf einen Signal-Bot, der Antworten sucht und über Instant-Message liefert. Er ist darauf beschränkt, den Signal-Konten der Familie zu antworten; Anfragen von Dritten ignoriert er.
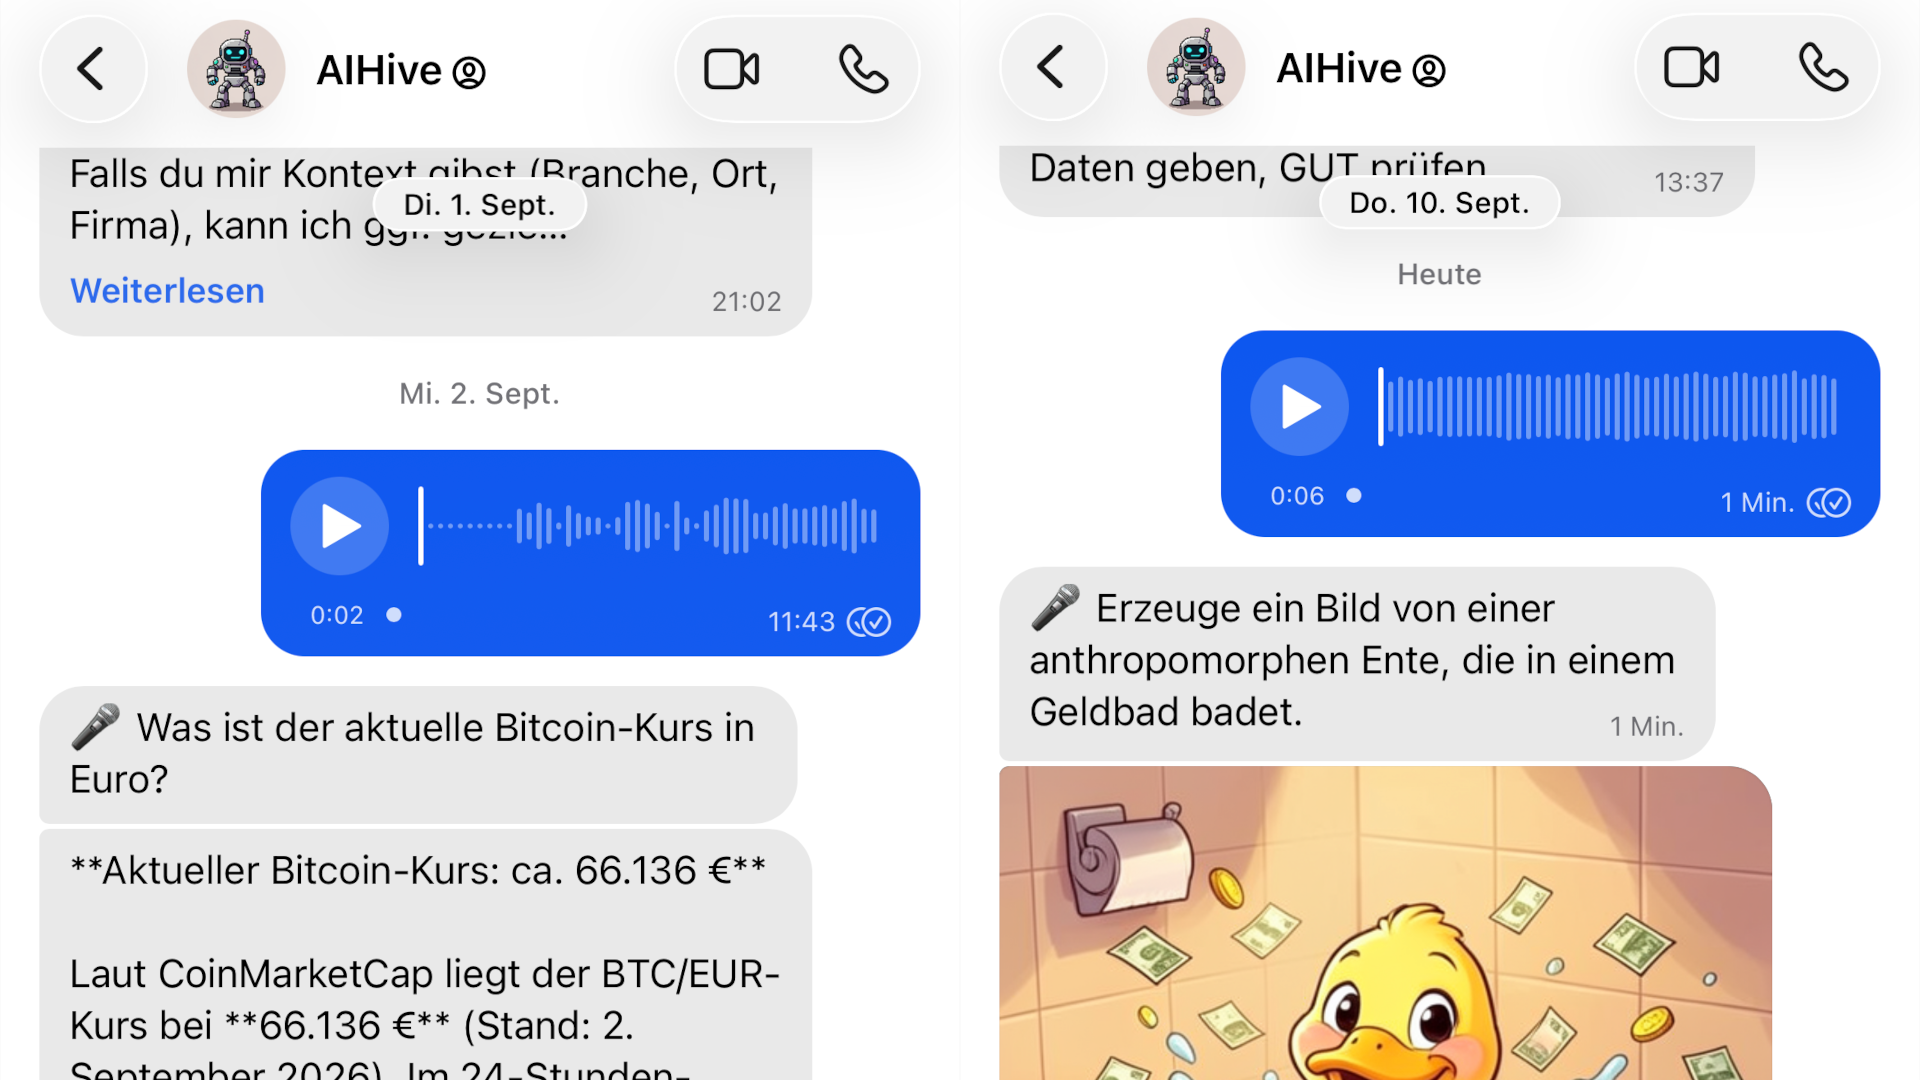
Der Signal-Agent hat nicht ganz den Funktionsumfang wie die ObenWebUI-Oberfläche im Heimnetz. Aber fürs Handy und unterwegs reicht er aus: suchen geht. Und Audionachrichten versteht er auch.
Zum Schluss: Die härteste Aufgabe!
Jetzt muss der Heim-Admin nur noch eine Aufgabe lösen - die härteste: er muss seine Familie davon überzeugen, die Heim-KI auch zu nutzen.
Viel kommerzielle Konkurrenz hat sie ehrlich gesagt zuhause bislang nicht - aber konkurrenzfähig ist sie allemal. Und ich merke, dass ich bei Standard-Fragen und -Aufgaben inzwischen tatsächlich selbst lieber auf die eigene KI-Maschine zugreife – mit einer Mischung aus Heimwerkerstolz und Freude an der gewonnenen Souveränität.
Wer jetzt sagt: Das will ich auch - der Code für die OpenWebUI-zu-Signal-Brücke und den Modell-Router findet ihr auf 🌐 git.h2h.de, ansonsten mit Fragen gern direkt melden!