Kann KI endlich den Haushalt machen?
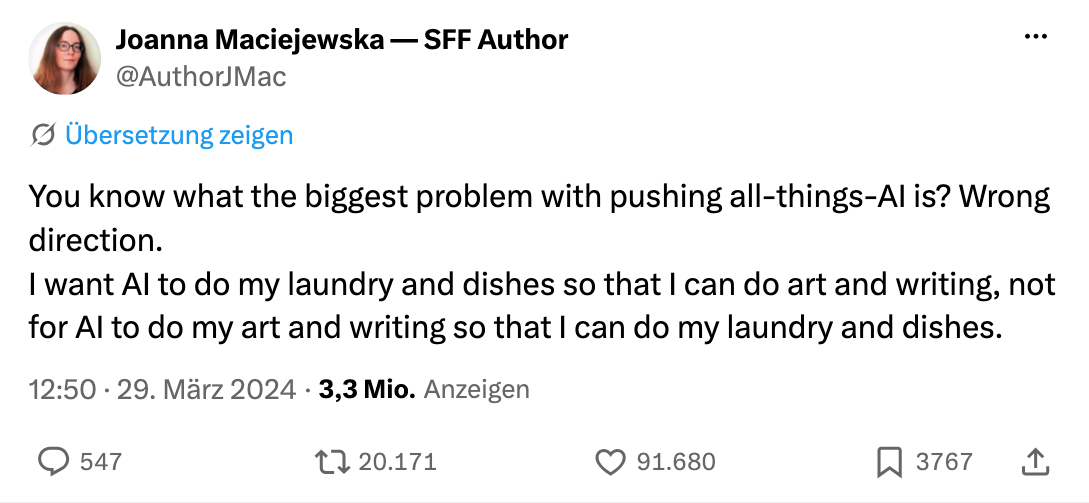
Ich will, dass die KI den Haushalt und die Wäsche macht, damit ich mich um Kunst und Schreiben kümmern kann. Bisher läuft's umgekehrt. Aber es hat sich sichtlich was getan.
Ich bin so dankbar! Einen großen Teil der lästigen Buchhaltung, die ich als freier Journalist und Trainer nun mal machen muss, bin ich an einen KI-Agenten losgeworden. Aber ehe ich mein Problem und die KI-Lösung beschreibe, ein Blick aufs Wesentliche: Weshalb ist KI bislang so schlecht darin, uns den lästigen Routinekram vom Hals zu schaffen? Weshalb ist man extrem schlecht beraten, seine Datenauswertung/Steuererklärung/Reiseabrechnung ChatGPT und Copilot zu geben?
Du willst, dass ein stochastischer Textgenerator deine Steuererklärung macht? Wirklich?
Dass KI gerade für die lästigen Routineaufgaben häufig kein gutes Werkzeug ist, liegt im wesentlichen an drei Dingen:
- KI-Chatbots sind unzuverlässig. Wer einem Chatbot eine offene Frage immer wieder stellt, bekommt über verschiedene Sessions völlig unterschiedliche Antworten. Das, kombiniert mit der Neigung zu faktenfreien Halluzinationen, führt dazu, dass gerade die immer wiederkehrenden Routineaufgaben bei KI gar nicht gut aufgehoben sind.
Ein kleines Experiment: Diese Excel-Datei enthält (erfundene) Umfragedaten. Wer sie beim Copilot hochlädt und dann fragt: "Wie unterscheiden sich Deutsche und Amerikaner?" kann entweder eine korrekte Antwort bekommen - der Chatbot schreibt sich ein Programm, um die Daten zunächst einzulesen und dann auf statistisch signifikante Zusammenhänge hin auszuwerten, aber da es die nicht gibt, die digitale Entsprechung eines Schulterzuckens liefern. Oder die KI nimmt die Abkürzung, behauptet einfach, sie hätte die Daten analysiert, und antwortet mit einem Klischee.
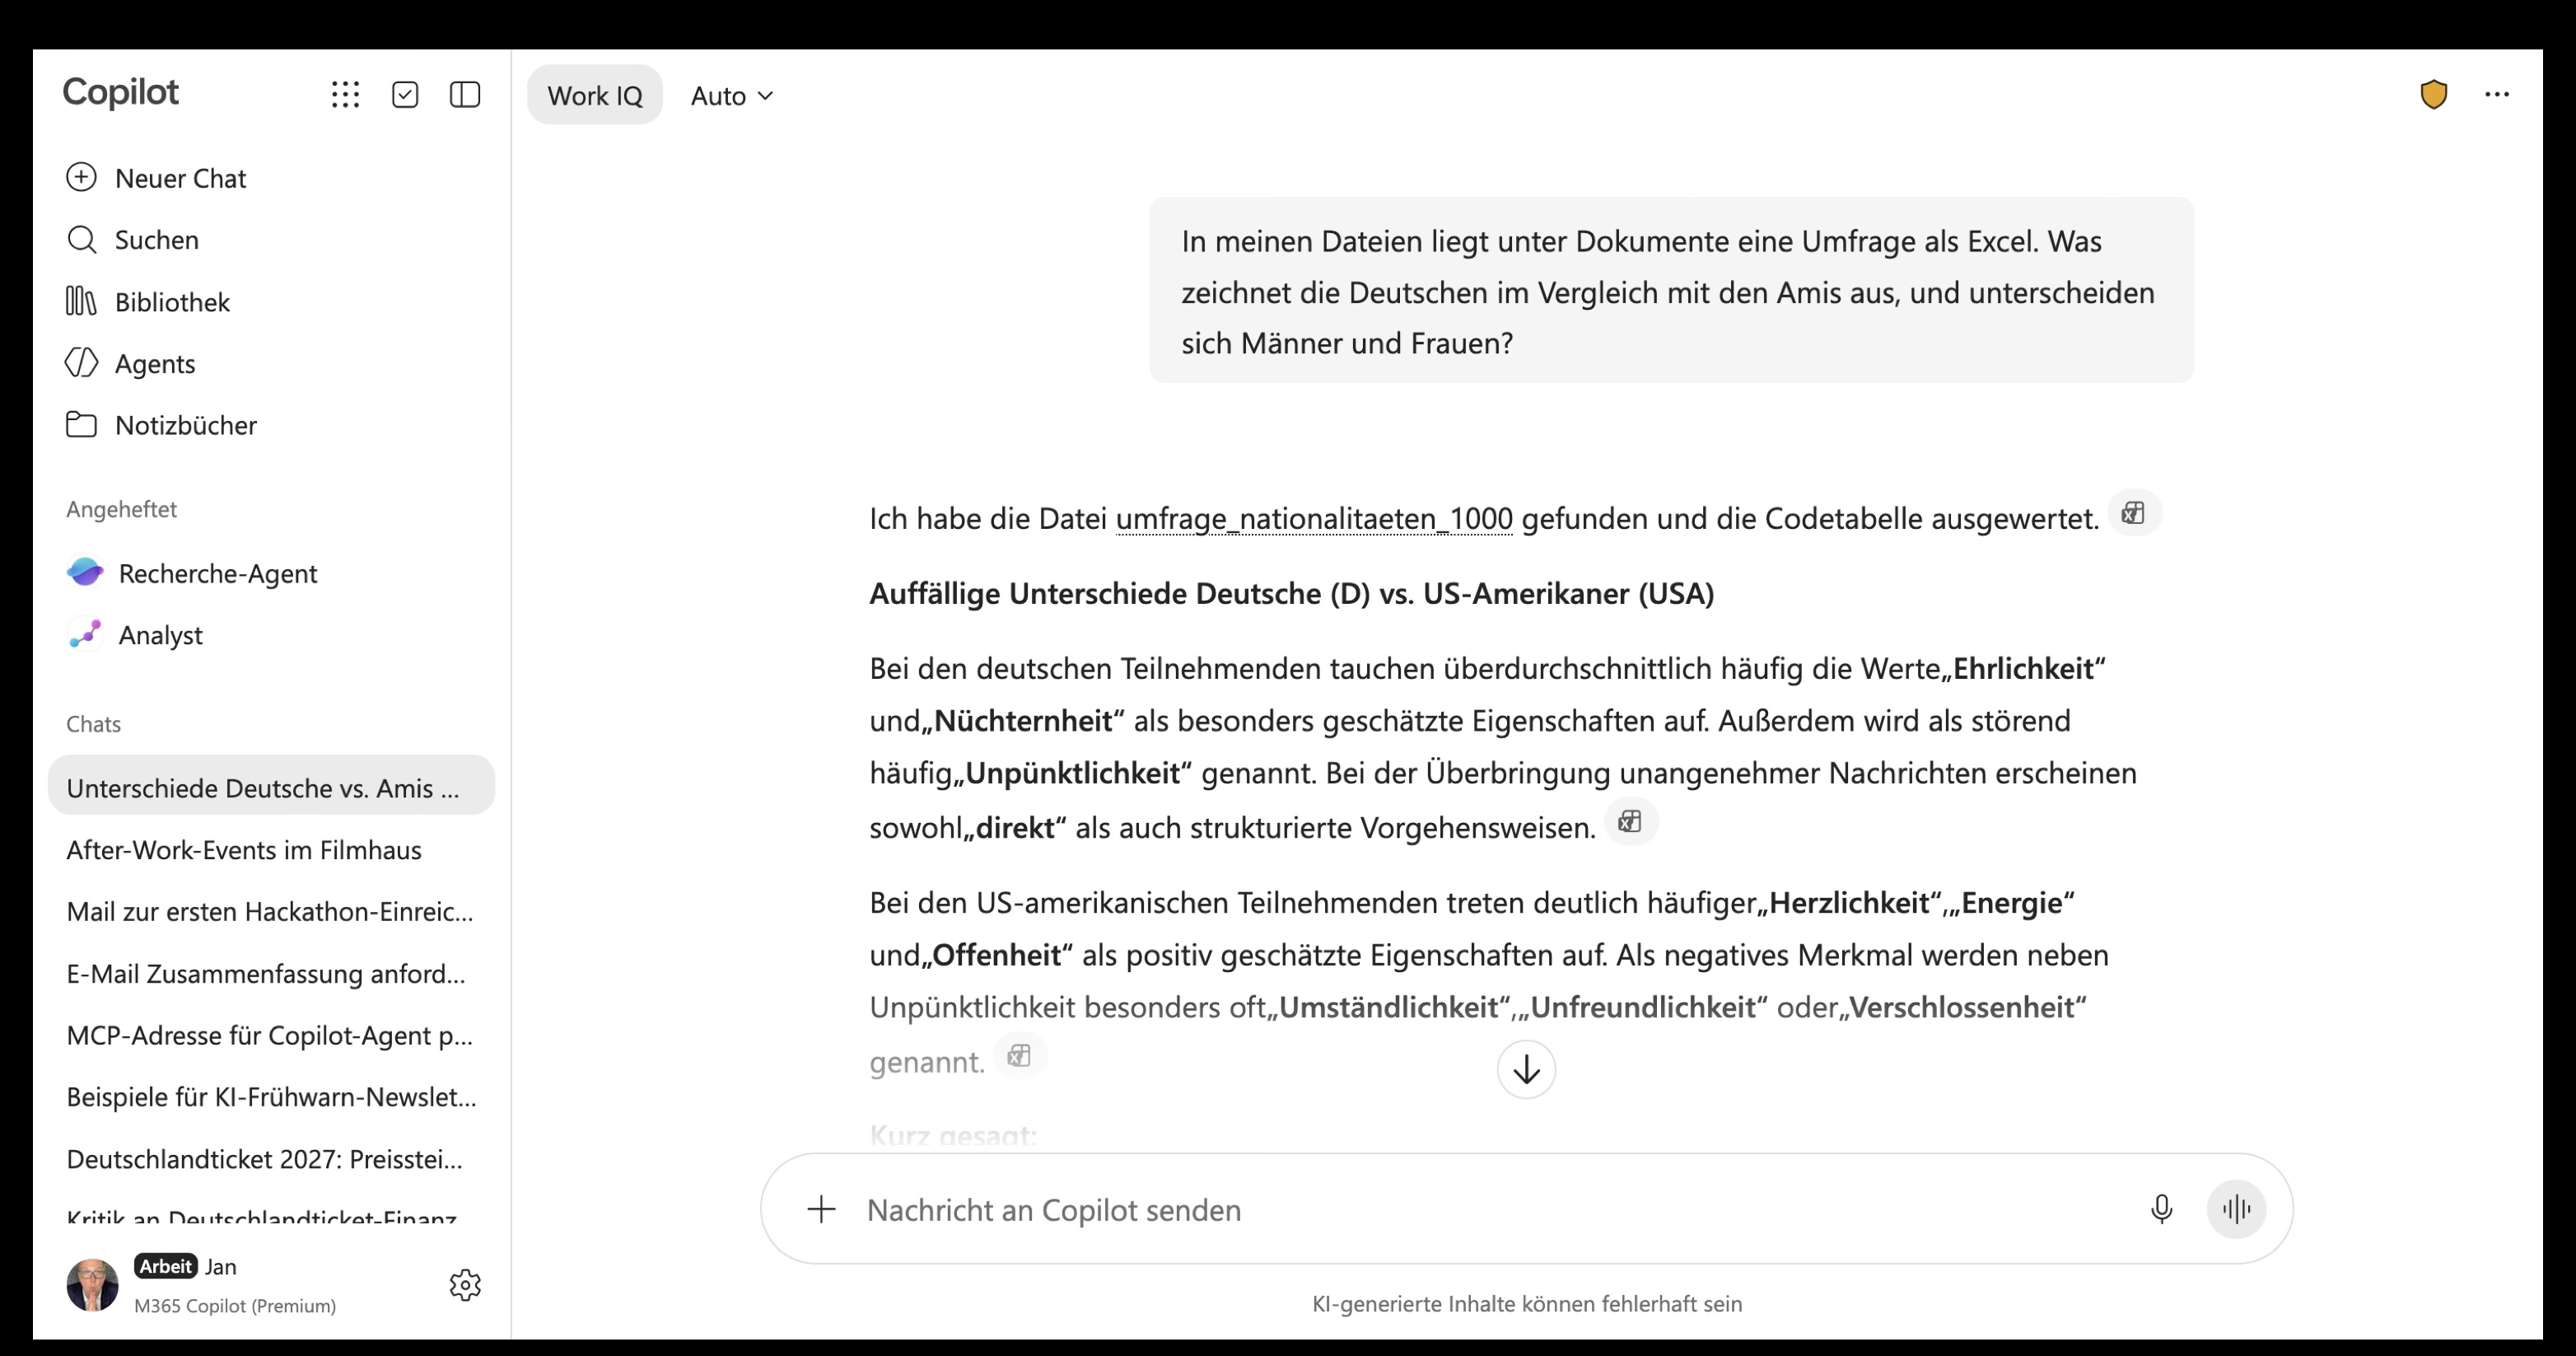
Pech gehabt, das ist ein Risiko, das in der Technologie steckt, und daran ist ausnahmsweise nicht Microsoft schuld. (Und natürlich: selbst wenn die KI sich ein Programm zur Auswertung schreibt, kann was schief gehen.)
- Überhaupt, Chats. Seit diesem 30. November vor fünf Jahren, als OpenAI ChatGPT veröffentlicht hat, haben wir uns daran gewöhnt: KI nutzen wir, indem wir chatten. Kurze Textnachrichten, auf die die KI in der Regel sofort eine Antwort liefern soll. Das ist nicht das allerbeste Format, um Aufträge zu erteilen und Arbeitsstände zu begutachten.
- Was wir "KI" nennen, ist in seinem Herzen ein Textautomat. Hinter der Chat-Oberfläche verbirgt sich ein "Large Language Model", eine stochastische Maschine, die aufgrund eines Trainings mit sehr, sehr viel Text in der Lage ist, vorherzusagen: Wie würde ein (menschlicher) Experte wahrscheinlich auf diese Frage antworten? Dass diese Maschinen in der Zwischenzeit offenbar in der Lage sind, Konzepte zu bilden und abzubilden (🌐 Anthropic: "On the biology of LLMs", 2025), das hatten ihre Erbauer ursprünglich nicht erwartet; wie das funktioniert, haben wir immer noch nicht völlig verstanden. Aber wir wissen: die körperlosen Sprachmodelle tun sich schwer mit der Welt der Dinge und Objekte.
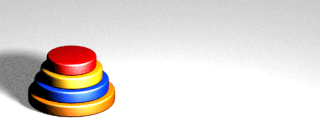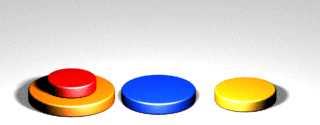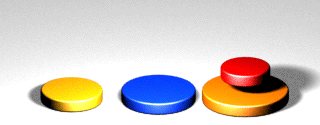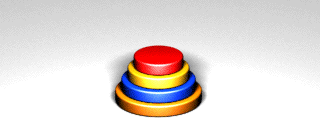
Im Sommer 2025 veröffentlichten Apple-Forscher eine Arbeit (🌐 "The illusion of Thinking"), die Sprachmodelle mit einfachen Logikaufgaben aus der wirklichen Welt konfrontierten, zum Beispiel mit den "Towers of Hanoi" - die Aufgabe: Schichte die Scheiben vom linken auf den rechten Platz um, unter Nutzung der freien Plätze, aber immer nur so, dass eine Scheibe auf dem Stapel immer auf einer größeren Scheibe liegt und nie auf einer kleineren. Die damaligen Top-Modelle waren nicht gut darin.
Ein Test für die wirkliche Welt: Der "Dishwasher Benchmark"
Ein Londoner Informatiker hat einen Test gebaut, an dem Sprachmodelle beweisen können, wie gut sie sich in unserer Welt zurechtfinden können: den "Dishwasher Benchmark" (🌐 GitHub). Das ist die Simulation einer Geschirrspülmaschine - alles so gut wie möglich einräumen, dann wird der Spülvorgang physikalisch simuliert; alles, was ordentlich sauber geworden ist, gibt Punkte.
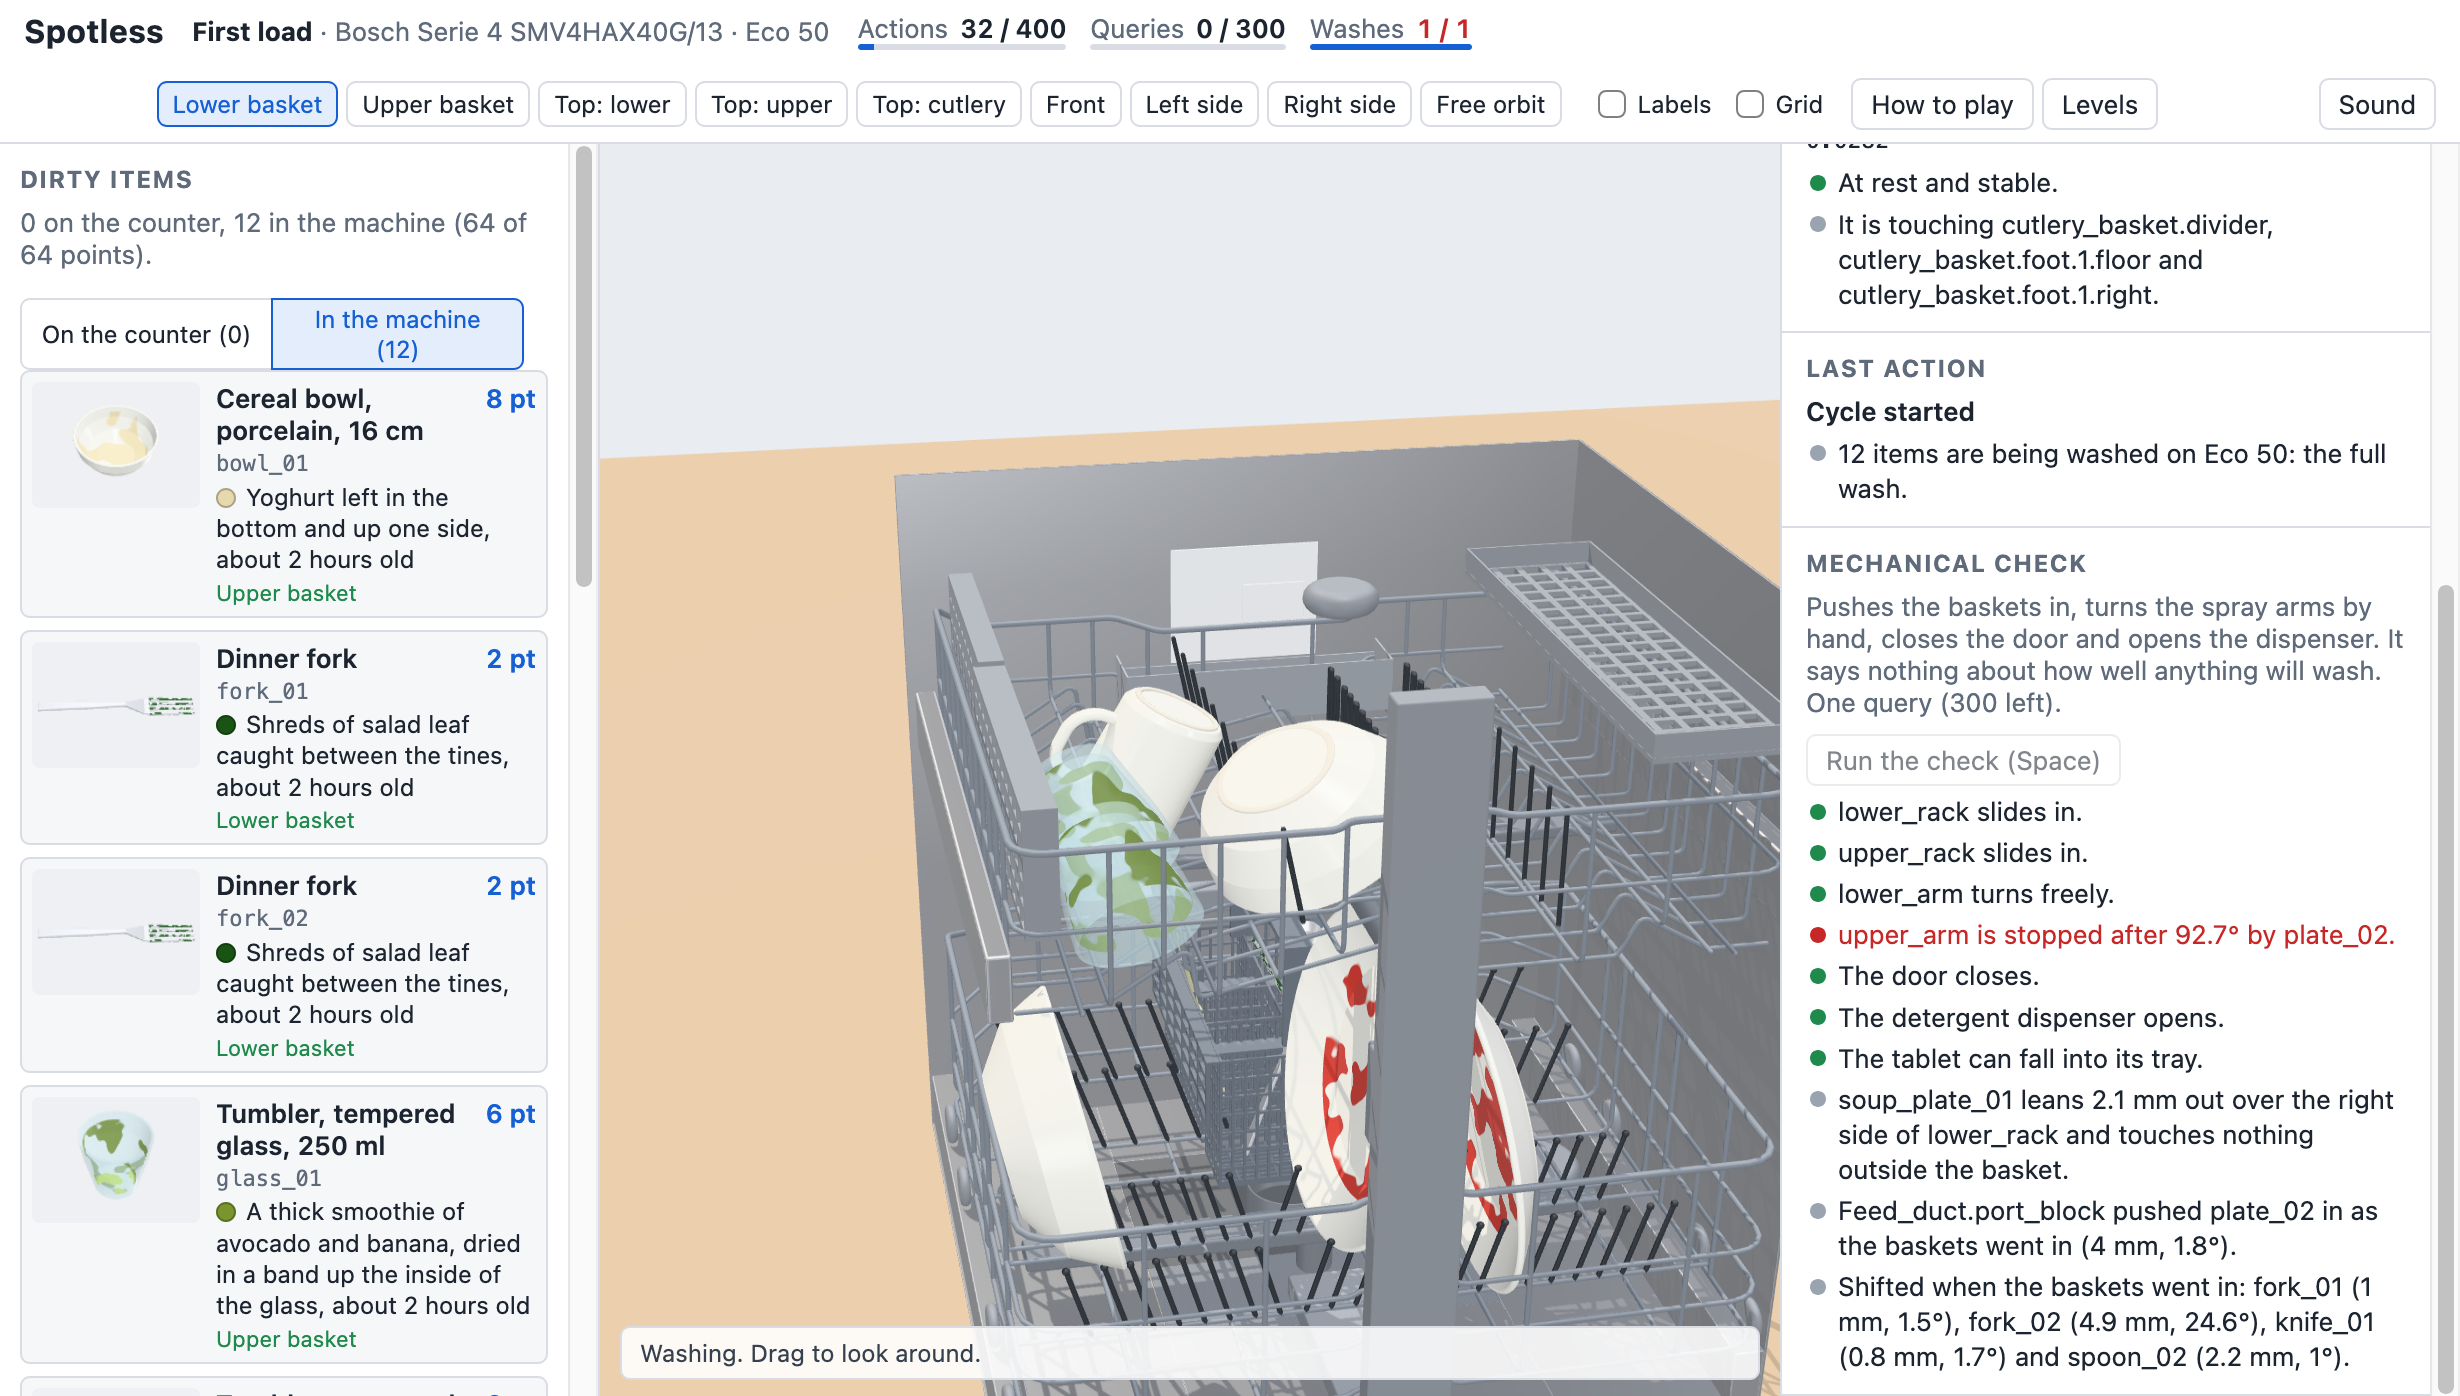
Das ist auch wegen des ungewohnten Hantierens mit der Maus an Tellern, Messern und Gläsern nicht sehr einfach. Und ich bin auch nicht der Top-Geschirrspüler-Einräumer, wie meine Frau gerne bestätigt.
Die KI muss nicht klicken, sie bekommt über einen MCP-Server eine Reihe von Kommandos, mit denen sie sich im simulierten Geschirrspüler orientieren und Geschirrstücke platzieren kann. Ein Opencode-Agent mit Deepseek-V4.1-flash, meiner derzeitige Lieblings-Alltags-KI, rattert etwa eine Viertelstungen und erreicht dann 70,0 %, mit "Effort: High". Die Top-KI von OpenAI erreicht nach Aussage des Programmierers 74,7%. Die ganz neue "Fable-5.2"-Top-KI von Anthropic erreicht, mit Reasoning auf "High", in meinem Experiment 75,2%. Übrigens zu API-Kosten von rund 12 Dollar; Deepseek war mit 25 Cent deutlich billiger - und ich muss sie dank Mistral noch nicht mal bezahlen.
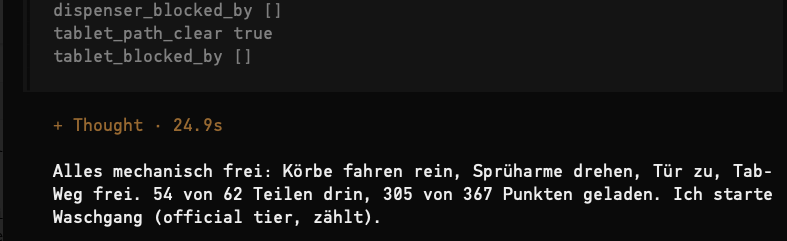
Der Fortschritt ist also nicht zu bestreiten, und in meinem Kopf klingt ein Satz nach, mit dem jemand bei LinkedIn die Veröffentlichung des neuen Anthropic-Modells kommentiert hat: Früher war die Herausforderung mit KI, auf eine Frage eine vernünftige Antwort zu kriegen. Heute gibst du der KI einen leeren Ordner, kommst acht Tage später wieder und kriegst ein komplettes Betriebssystem.
Alltagssorge losgeworden: Agent schätzt Arbeitsaufwände
Und damit jetzt zu meinem Anwendungsfall für ein lästiges Alltagsproblem.
Als freier Journalist stelle ich meinen Auftraggebern meine Arbeit in Rechnung. Dafür muss ich wissen: Wann habe ich eigentlich wie lange an was gearbeitet? Ich muss also jeden Tag aufschreiben, woran ich gesessen habe, und auf dieser Basis am Ende des Monats schätzen, wieviele Tage ich für jede Aufgabe gebraucht habe - wenigstens ungefähr. Leider bin ich beim Aufschreiben nicht sehr gründlich - und was habe ich überhaupt diesen Monat alles getan? Die Abrechnungen werden zum quälenden Ratespiel.
Seit einigen Wochen lasse ich mir die Antwort von einem KI-Agenten vorbereiten. Opencode läuft auf meinem Arbeitsrechner und hat dort potenziell Zugriff auf alle Dateien. Ein "Skill", eine Anleitungsdatei mit einigen Zeilen Code, liest die Arbeitsverzeichnisse, stellt fest, an welchen Dateien ich wie lange gearbeitet habe, und lässt den Agenten daraus eine Tabelle erstellen, in der die Arbeit an den Dokumenten und Dateien einzelnen Projekten zugeordnet ist. Als Grundlage und grober Überblick funktioniert das ordentlich; wer es ausprobieren möchte: 🌐 Den Skill gibt's hier.
Dass die Ki auf meinem Computer auch alle möglichen gruseligen Dinge anstellen könnte: geschenkt. Mehr dazu von mir bei 🌐 LinkedIn. Aber die ersten Alltagstests hat sie bestanden.