Offene Modelle FTW: Wovor Dario und Sam wirklich Angst haben
KI bremsen und regulieren: Von Dario Amodei, dem Chef des KI-Großkonzerns Anthropic, waren erstaunliche Töne zu hören; begleitet von einem Chor von Stimmen, die davor warnen, dass KI die Menschheit auslöschen könnte, und einer Flut von Meldungen über hackende KI-Agenten. Aber wenn Amodei und andere KI-Anführer eine Regulierung zu ihren Bedingungen fordern, muss man immer auch mitdenken, dass sie dabei eigene Interessen verfolgen: unter anderem, sich gefährliche Konkurrenz vom Hals zu schaffen.
Letzte Woche habe ich hier über Jev geschrieben, eine neue KI, die schnell, effizient und genau auf Fragen antwortet wie: Ist das ein Kommentar oder ein Erklärtext? Wie polemisch auf einer Skala von 1-10 ist er formuliert? Und um welche Themen geht es? Ich bin davon ziemlich begeistert, und sofort sind mir 13 verschiedene Ideen eingefallen, wie man das für Stories und Recherchen nutzen kann.
Richtig großartig wäre das allerdings erst, wenn ich das Modell auch auf meinen eigenen Computern laufen lassen und nutzen könnte, denn gerade, wenn die KI-Leistung beschränkt ist, ist effiziente Entscheidungs-KI wie Jev ideal: So ein KI-Modell würde selbst auf einem altersschwachen Büro-Laptop laufen können! Woher ich das weiß? Auch daher, weil es längst ein KI-Projekt gibt, das das gleiche schaffen will wie Jev - es heißt Laya, ist open-source - das heißt nicht nur: kostenlos nutzbar, sondern auch: sein Erfinder beschreibt genau, wie das geht. (🌐 Blog auf dev.to) Zugegeben: Laya kann mit dem kommerziellen Jev nicht konkurrieren, das haben meine Tests leider deutlich gezeigt.
Noch nicht. Denn spannende Open-Source-Projekte entwickeln sich oft rasend schnell; werden verbessert, geglättet, professionalisiert. Was man sich herunterladen kann, wird genutzt - von Forschenden über KI-Teams in Firmen bis zu engagierten Privatpersonen. Eine Vielzahl von Menschen teilen ihr Wissen und treiben die Projekte dann voran. Ich glaube: Davor haben die großen amerikanischen KI-Konzerne wie OpenAI (ChatGPT) und Anthropic (Claude) eine Heidenangst.
Ich glaube auch: Völlig zu Recht.
Offene Modelle sind alltagstauglich
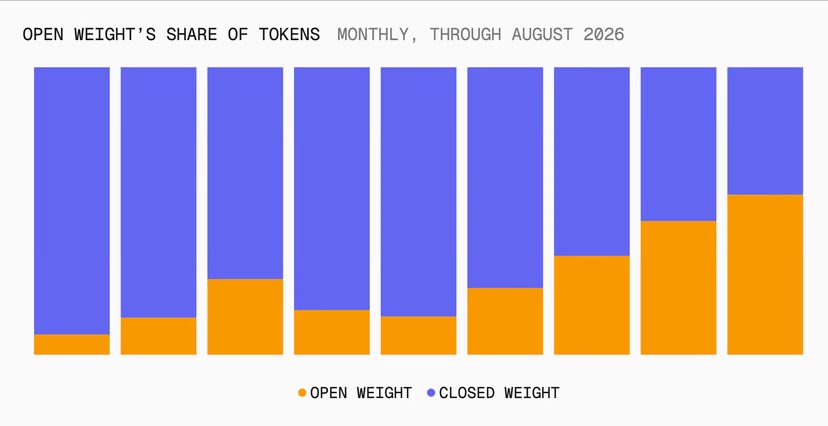
Modelle, die man frei herunterladen kann, werden allmählich zur ernsten Bedrohung für das Geschäftsmodell von OpenAI und Claude. Vercel, ein mittelgroßer Anbieter von KI-Rechenleistung, hat neulich eine Statistik publiziert, dass die Nutzung von offenen KI-Modellen erstmals die von kommerziellen Modellen übertroffen hat (🌐 Vercel-Blog): von April bis August ist der Anteil der Tokens, der von offenen Modellen verarbeitet wird, von 13 auf 56 Prozent gestiegen.
Denn: die offene Konkurrenz ist nicht nur günstiger: sie ist richtig gut. Aus meiner Erfahrung:
- Die derzeit stärkste europäische KI, Mistral-medium-3.5, ist verglichen mit den Top-Modellen allenfalls mittelklein. Aber sie ist stark, wenn es darum geht, journalistische Texte auf deutsch zu beurteilen.
- Für den Chatbot-Alltag nutze ich als kostenpflichtige KI gerne Deepseek-V4-Flash, das etwa auf dem Niveau eines älteren Claude-Sonnet-Modells arbeitet - aber zu einem Bruchteil der Kosten.
Und am oberen Ende haben Modelle wie GLM5.3 oder Kimi-K3 den Abstand auf die führenden kommerziellen KIs so weit verringert, dass eine aktuelle Studie ihn nur noch auf vier Monate schätzt: Wer GPT-6 und Co. nutzt, bezahlt diesen viermonatigen Vorsprung mit den fünffachen Kosten. (🌐 ArsTechnica)
Das sind schlechte Nachrichten für die Investoren bei OpenAI und Anthropic, die die Milliarden-Investitionen in Forschung und Hardware eines Tages mit Zins und Zinseszins bei uns abkassieren wollen. Das sind gute Nachrichten, weil sie uns Alternativen zu OpenAI und Anthropic eröffnet - abgesehen von dem Bastler-Charme, den es hat, wenn ich ein KI-Sprachmodell auf einem eigenen Computer installieren kann, um den leistungsstarken Recherche-Helfer 🌐 Spotlight anzutreiben.
Sind wir ehrlich: Die Qwen3.8-KI auf meinem Macbook ist kein Ersatz für ChatGPT und Claude. Sie produziert häufiger Fehler oder Erfindungen - das ist der Preis, den ich dafür zahle, dass die ganzen unendlich vielen Trainingsdaten auf nur wenige Dutzend Gigabyte zusammenkomprimiert sind. Wie sich das auswirkt, kann man zum Beispiel sehen, wenn man sich ein kleines Spiel von der KI programmieren lässt - das ist mit dem kleinen lokalen Modell langsam und fehleranfällig. Aber alle diese Probleme lassen sich lösen, wenn ich ein Unternehmen bin, und dafür im Zweifel einfach einen Dienstleister miete - dann ist das offene Modell günstiger, aber nicht schlechter.
Transparenz ist gut - sie macht KI verständlicher
Forschung ist offen - man teilt Annahmen, Methoden und Ergebnisse, positive wie negative; so können Wissenschaftler von einander lernen. Das macht die Forschung besser. Offenheit bei KI liefert uns nicht nur gute KI zu niedrigeren Kosten, sondern bietet auch ein Fenster in das, was ein KI-Sprachmodell tut. Werkzeuge wie die "Jakobi-Linse", mit denen wir einem Sprachmodell dabei zuschauen können, wie es Begriffe findet, und das ich neulich mal hier geschrieben habe, hängen davon ab, dass man die Gewichte des Modells herunterladen und verändern kann.
Das man das kann, ist nicht ohne Preis und nicht ohne Risiko - die Regulierungswünsche der großen Firmen haben durchaus konkreten Hintergrund. Einen offenen Modell kann man ohne große Schwierigkeiten alle inneren Sicherheitssperren abtrainieren und es dann zum Beispiel als Hacker-in-a-box einsetzen - oder um Biowaffen zu erfinden oder Propaganda-Fluten zu erzeugen.
Die dicken Aaaaabers
Das ist nicht das einzige, was man über offene Modelle eben auch sagen muss:
- Digitaler Individualverkehr ist keine Lösung: Die Vorstellung: Ich kaufe meinen eigenen KI-Rechner mit Super-Grafikkarte, und dann bin ich unabhängig - ist nicht nur ganz schön teuer in der Umsetzung. Das ist auch ziemlich ineffizient und genau so wenig ein idealer Weg, wie es eine Lösung für alle Verkehrsprobleme ist, dass jeder sich ein Auto kauft.
- Open Weights ist nicht Open Source: Die Modelle, die man sich herunterladen kann, sind nur zum Teil offen. Mit welchen Daten sie trainiert sind, verraten die chinesischen Anbieter nicht; sie legen auch nicht alle Methoden so offen, wie das in der Forschung üblich ist. Wie stark Standpunkte der chinesischen Staatspropaganda mit trainiert wurden, oder sogar die Neigung, Hintertüren in Code einzubauen: wir wissen es nicht. Und auch offene Modelle können mit sehr stark beschränkenden Nutzungsbedingungen kommen.
- Unklare Finanzierung: Wer sich ein Open-Source-Programm herunterlädt, hat in der Regel eine naive Vorstellung davon, wie sich so ein Open-Source-Programm trägt. Projekte für den Alltag entstehen eben nicht quasi von selbst dadurch, dass jeder ein bisschen Zeit und Geld investiert und gelegentlich spendet. Bei allen Vorteilen, die geteilter Code bietet, oft hängen entscheidende Teile an Firmen, die Geld verdienen müssen, und manchmal an Einzelpersonen - das schränkt die Verlässlichkeit ein, und am Ende ist es dann wirklich wie in dem bekannten XKCD-Comic. Bei der KI spielt öffentlich finanzierte Forschung derzeit kaum noch eine Rolle - weil ihr Rechenleistung und Forschungskapazität fehlen. Woher kommt sie bei den Open-Weights-Modellen?
- Neue Abhängigkeiten, neue Gefahren: Die stärksten offenen KI-Modelle kommen derzeit aus China. Dass die Labore von Alibaba, Tencent, Moonshot und Z.AI sie einfach so zum Herunterladen anbieten, hat zum einen wirtschaftspolitische Gründe - das erste Deepseek-Modell allein löste regelrechten Boom von KI-getriebenen Produkten in China aus (🌐 Rest of World) - es ist aber auch eine geostrategische Enscheidung eines autoritären Regimes. Und wir sind von der Gnade der Finanziers abhängt, das hat eins der ersten wichtigen Open-Weights-Projekte gezeigt: Die Entwicklung lokaler KI-Modelle bekam ihren ersten großen Schub durch die Llama-Modelle von Facebook/Meta - bis Mark Zuckerberg die Lust verlor, den großen Labs in die Suppe zu spucken. Das derzeitige Top-Modell ist wieder Geschäftsgeheimnis.
Mein Traum: Mehr Rückhalt für Open-Weights- und Open-Source-KI!
Die Blüte der Spitzen-Open-Weights-Modelle kann schnell wieder vorbei sein, wenn China seine strategischen Ziele erreicht hat. Aber im Alltag kommt es weniger auf die Top-Leistung an als auf Anpassbarkeit, niedrige Kosten, Unabhängigkeit und Privatsphäre.
Zwei eher unspektakuläre KI-Modelle sind genau aus dieser Vorstellung entstanden:
- das "Apertus"-Modell der ETH Zürich, wirklich komplett open source, das vielleicht deutlich bescheidener ist als die neueren Modelle aus China und USA, aber dafür sehr gut Schwyzerdütsch spricht - offene Modelle sind stark in der Nische.
- Und in München haben Forschende gemeinsam mit der Telekom ein Modell namens "Soofi" trainiert, das auf einem offenen Modell des Chipherstellers NVIDIA basiert und eine mögliche Grundlage für angepasste deutsche Spezial-Modelle ist.
Fun Fact: das "Soofi"-Modell ist im Training mit dem Wasser der Eisbachwelle gekühlt worden - das ist die, auf der die Surfer im Englischen Garten unterwegs ist. Wenn das allein keinen Grund für wohlwollendes Interesse ist...